Evropská suverénní AI: co znamená v praxi
Suverénní AI jsou čtyři samostatné otázky: budova, provozovatel, váhy a hodnoty. Na co umí Evropa odpovědět dnes a co můžeš udělat ještě toto čtvrtletí.
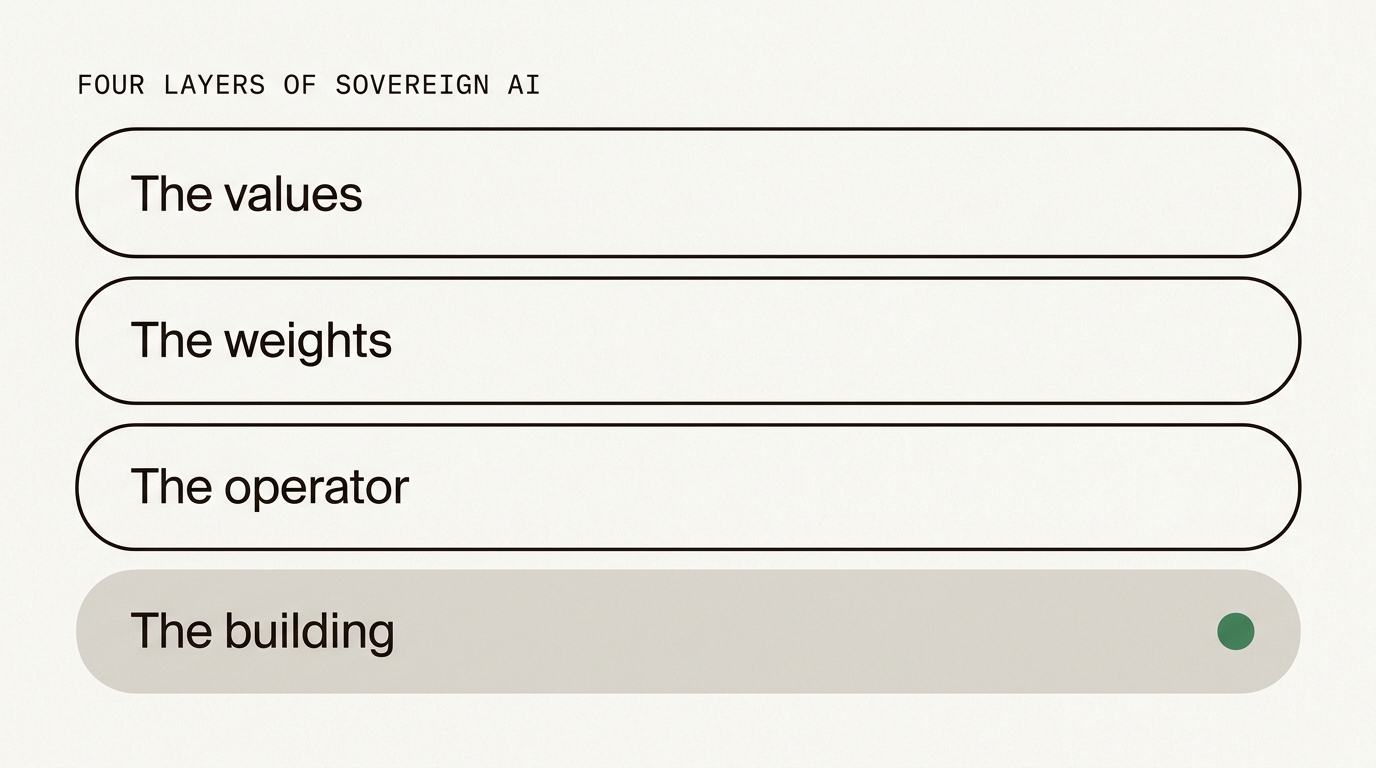
Suverénní AI není jedna vlastnost. Jsou to čtyři otázky naskládané na sobě: kde stojí hardware, který stát může přinutit firmu, jež ho provozuje, kdo model natrénoval a čí předpoklady si model nese. Evropa umí dobře odpovědět na první, na druhou s výhradami a na třetí a čtvrtou jen zčásti. Kdo ti prodává všechny čtyři v jednom slově, prodává ti ambici.
Stojí za to to říct na rovinu dřív, než do hovoru vstoupí jakýkoli produkt, včetně našeho. Užitečná podoba téhle debaty nezní „evropské, nebo americké“. Zní: kterou vrstvu stacku tahle konkrétní zátěž opravdu potřebuje a kolik stojí tu vrstvu přesunout?
Co suverénní AI doopravdy znamená
Slovo přišlo z debaty o výpočetním výkonu, kde mělo přesný význam: stát by měl být schopen provozovat kritické systémy bez svolení jiného státu. Když se přeneslo na AI, roztáhlo se na všechno od PSČ datových center po politické sklony chatbota a cestou ztratilo většinu své užitečnosti.
Rozlož ho zpátky na části a každou z nich půjde ověřit.
Suverenita není odznak na landing page. Jsou to čtyři otázky se čtyřmi různými odpověďmi a poctiví poskytovatelé ti řeknou, na které z nich odpovídají.
Budova je geografie: ve které zemi hardware stojí. Provozovatel je jurisdikce: který právní řád zavazuje firmu, jež ten hardware provozuje. Váhy jsou původ: kdo model natrénoval, na jakých datech a pod jakou licencí. Hodnoty jsou chování: co model řekne, co odmítne a co o tvé části světa potichu splete.
Kdo dnes v Evropě dodá kterou vrstvu
| Vrstva | Otázka | Evropa dnes |
|---|---|---|
| Budova | Kde stojí hardware? | Vyřešeno. Evropská kapacita existuje a dá se objednat |
| Provozovatel | Který stát může provozovatele k něčemu přinutit? | K dispozici pro inferenci, těžší pro hosting, databáze a platby |
| Váhy | Kdo model natrénoval? | Skromné, ale zlepšuje se to a mezera ve výpočetním výkonu se právě zaplňuje |
| Hodnoty | Co model řekne a co odmítne? | Zčásti, a spíš díky dokumentaci než tréninku |
Čím výš jdeš, tím jsou vrstvy těžší a tím víc stojí. Pronájem evropského výpočetního výkonu je nákupní rozhodnutí. Natrénovat v Evropě konkurenceschopný špičkový model je víceletý průmyslový projekt a přesně na to je určená současná vlna financování z EU.
Kde hardware fyzicky stojí?
- Co Evropa umí dodat dnes
- Vyřešeno. Evropská kapacita datových center existuje, dá se objednat a roste.
- Co dělá Union AI
- Veškerá AI inference běží na infrastruktuře uvnitř Evropské unie.
Jedna zelená tečka ze čtyř. Kdo dnes tvrdí, že má všechny čtyři, popisuje ambici, ne stack, který si můžeš koupit.
Existují evropské LLM, které stojí za to používat?
Ano, a poctivý obraz je spíš mladý obor než hotová věc. Dělí se na dva druhy úsilí.
První je komerční. Evropské laboratoře vydávají open-weight modely, které si můžeš stáhnout a provozovat sám, a jejich menší modely jsou pro běžnou práci opravdu konkurenceschopné. Tahle část evropského stacku už dnes funguje v produkci.
Druhý je veřejný. OpenEuroLLM je konsorcium evropských univerzit, center HPC a firem financované z programu Digitální Evropa, které vyvíjí otevřené základní modely pro úřední jazyky EU a spolu s vahami zveřejňuje data, kód a vyhodnocení. Na té poslední části záleží víc než na skóre modelů: model, jehož trénovací data a vyhodnocení jsou veřejné, je model, který můžeš auditovat, a ve špičce se dnes auditovat nedá skoro nic.
Pod obojím leží výpočetní výkon. Program Komise pro AI gigafactories mobilizuje přes nástroj InvestAI 20 miliard € na rozsáhlou trénovací kapacitu v Evropě a na neformální výzvu k vyjádření zájmu přišlo 77 návrhů ze 16 členských států a 60 lokalit, přičemž stavba první lokality se čeká od roku 2027. Jestli to mezeru ve schopnostech zavře, je otevřená otázka. Znamená to ale, že odpověď v roce 2029 nebude stejná jako dnes, a to je důvod udržet si přenositelný stack, ne čekat.
Dá se model natrénovat na evropských hodnotách?
Zčásti, a to spojení si zaslouží víc pozornosti, než obvykle dostává. „Natrénovaný na evropských hodnotách“ dělá tři různé práce a ověřit se dají jen dvě z nich.
Jazyk je hodnota a dá se změřit
Model, který zvládá nizozemštinu, finštinu, řečtinu a portugalštinu stejně dobře jako angličtinu, je pro evropské uživatele jiný produkt než model, který je bere jako vedlejší věc. Jazykové pokrytí otestuješ za jedno odpoledne: spusť vlastní prompty ve vlastních jazycích a porovnej. Je to ten nejužitečnější test v celé debatě o suverenitě a před nákupem ho skoro nikdo nedělá.
Odmítání prozradí trénink
Některé open-weight modely jsou trénované v právních systémech s vlastními citlivostmi a vyhýbají se faktickým otázkám o politice nebo historii, které by evropský uživatel považoval za úplně běžné. Bereme to jako vadu, ne jako bezpečnostní prvek. Když náš systém zachytí takové odmítnutí v první větě odpovědi, odpověď zruší a otázku spustí znovu na modelu, který tohle slepé místo nemá, nejvýš jednou na požadavek, a v hlavičce X-EU-Routed ti řekne, že se to stalo. Skutečná bezpečnostní odmítnutí ale neobcházíme: ta zůstávají odmítnutá, protože přesměrovávat, dokud model nevyhoví, je automatizovaný jailbreak.
Všechno ostatní je dokumentace, ne trénink
Zbytek toho, co lidé myslí hodnotami, tedy že je model férový, vyvážený a vhodný, se z marketingové stránky ověřit nedá. Ověřit se dá, jestli poskytovatel zveřejňuje model, licenci, systémový prompt a naměřenou míru odmítání. My zveřejňujeme všechny čtyři na naší stránce o transparentnosti AI, včetně toho, v čem vypadáme hůř.
Potřebuje bezpečnost dat evropský model?
Ne, a když se ty dvě věci pletou, stojí to týmy skutečné peníze. Kde byl model natrénován a kde se zpracovává tvůj prompt, jsou dvě nezávislé skutečnosti.
Váhy jsou soubor. Stáhni si open-weight model, spusť ho na evropském hardwaru a tvůj prompt jde na ten hardware a zase zpátky, ať model natrénoval kdokoli. S vahami cestuje chování, ne tok dat. Proto může náš stack poctivě přiznat, že běží převážně na neevropských modelech, a přitom zpracovávat každý požadavek uvnitř Evropské unie, a proto je pro ochranu dat důležitější cesta požadavku než příběh o původu modelu.
Čtyři otázky o bezpečnosti dat, které stojí za to položit každému poskytovateli, evropskému i neevropskému: kde se zpracovává inference, jak dlouho se uchovávají prompty, používají se k tréninku a které strany v řetězci mají mateřskou společnost mimo EU. Naše odpovědi najdeš na stránce o dalších zpracovatelích, včetně těch nepříjemných.
Co můžeš reálně udělat ještě toto čtvrtletí
Suverenita jako nákupní rozhodnutí selhává, protože nic na trhu neprojde všemi čtyřmi vrstvami. Suverenita jako řada malých kroků funguje. Zhruba podle přínosu:
- Roztřiď zátěže dřív než dodavatele. Většina týmů má jeden díl opravdu citlivého provozu a velkou většinu běžného. Znát ten poměr mění to, které kompromisy stojí za zaplacení.
- Citlivý díl přesuň jako první. Smlouvy se zákazníky, personální spisy, záznamy o pacientech, nevydaný kód. Shrnování veřejných webových stránek nech, kde je.
- Vyžádej si seznam dalších zpracovatelů a klauzuli o tréninku písemně. Žádný obchodní hovor. Seznam s regiony a právnickými osobami, plus hledání slova „train“ v podmínkách.
- Drž rozhraní nudné. API kompatibilní s OpenAI má větší cenu než jakékoli tvrzení o suverenitě, protože dělá přechod levným. Přenositelnost je jediná forma vyjednávací síly, která přežije, když dodavatel změní názor. Naše je popsaná v dokumentaci API a co přechod reálně obnáší, najdeš v článku přechod na tři řádky.
- Zaznamenávej důkazy u každého požadavku. Hlavička, která uvádí úroveň, počty tokenů a cenu, udělá z tvrzení auditní stopu.
- Za šest měsíců test zopakuj. Evropská krajina modelů se hýbe rychleji než jakýkoli nákupní cyklus. Loňské předpoklady už neplatí.
Nic z toho nevyžaduje přestavbu a všechno to přežije, ať se trh pohne kterýmkoli směrem.
Kam zapadáme a kam ne
Union AI je evropská služba, která provozuje open-weight modely, veškerá AI inference běží na infrastruktuře uvnitř Evropské unie, platí se předem v eurech a účtuje po tokenech. Spodní vrstvu pokrýváme úplně, vrstvu provozovatele z větší části a o dvou nad nimi mluvíme otevřeně.
Naše modely jsou open weight pod licencemi Apache 2.0 a MIT a většina z nich nebyla natrénována v Evropě. Jediný v Evropě natrénovaný model v našem stacku je dnes model Mistral, na který na nejlevnější úrovni přepínáme, když hlavní model selže. Radši napíšeme tuhle větu, než abychom nechali práci udělat slovo suverénní.
Jak si to stojí proti třem dalším způsobům, jak v Evropě nakupovat AI, včetně řádků, kde prohráváme, najdeš v článku srovnání evropských poskytovatelů AI.
Nabídka je proto záměrně úzká. Pokud chceš, aby se tvoje prompty zpracovávaly v Evropě, u evropského poskytovatele, na modelech se zdokumentovaným chováním a s předvídatelným účtem, to existuje už dnes a začít můžeš tento týden. Pokud chceš evropský špičkový model natrénovaný na evropských datech, ten se staví, z veřejných peněz a podle zveřejněného harmonogramu, a nikdo, ani my, ti ho zatím prodat nemůže.
Časté dotazy
Co je suverénní AI?
Suverénní AI je představa, že stát nebo unie může provozovat AI systémy, které má pod kontrolou, za vlastních podmínek. V praxi se rozpadá na čtyři otázky: kde stojí hardware, který stát může provozovatele k něčemu přinutit, kdo model natrénoval a čí hodnoty model odráží. Většina dodavatelů odpoví na jednu z těch čtyř a slovo používá pro všechny.
Potřebuju evropský LLM, abych splnil AI Act?
Ne. AI Act (akt EU o umělé inteligenci) upravuje, jak se AI systémy vyvíjejí, dokumentují a předkládají lidem, ne to, kde byl model natrénován. Americký nebo čínský open-weight model můžeš používat v souladu s předpisy a evropský model můžeš používat v rozporu s nimi. Soulad je o tvých povinnostech jako poskytovatele nebo zavádějícího subjektu, ne o pasu vah.
Je open-weight model totéž co open source?
Ne, a na tom rozdílu záleží. Open weight znamená, že si model můžeš stáhnout a provozovat sám, obvykle pod licencí jako Apache 2.0 nebo MIT. Open source v plném smyslu by znamenal i zveřejněná trénovací data a reprodukovatelný trénovací kód, což většina open-weight vydání nenabízí.
Můžu použít čínský open-weight model a data si přesto nechat v Evropě?
Ano. Váhy jsou soubor. Jakmile si model stáhneš a spustíš na evropské infrastruktuře, tvoje prompty jdou na ten hardware a nikam jinam, ať model natrénoval kdokoli. S vahami necestují tvoje data, ale chování modelu, včetně témat, kterým se má podle tréninku vyhýbat.
Jsou moje data v bezpečí, když model běží v Evropě?
Odpadne jedna skupina rizik, ostatní zůstanou. Znamená to, že se tvoje prompty zpracovávají na evropské infrastruktuře a neposílají se do zahraničí, ale neříká to nic o uchovávání, trénování na tvých vstupech, řízení přístupu ani o tom, jestli má provozovatel mateřskou společnost mimo EU. Ptej se na všechny čtyři věci zvlášť.
Co znamená, že je model natrénovaný na evropských hodnotách?
V praxi tři ověřitelné věci: že dobře zvládá evropské jazyky, že na faktické otázky o politice a historii odpovídá, místo aby se jim vyhýbal, a že jeho trénovací data a chování při odmítání jsou zdokumentované. Není to slogan, který by šel ověřit, takže to ber jako sadu testů, které si sám spustíš, ne jako nálepku, které máš věřit.
Které projekty EU trénují evropské jazykové modely?
Nejviditelnější je OpenEuroLLM: konsorcium evropských univerzit, center HPC a firem financované z programu Digitální Evropa, které vyvíjí otevřené modely pro úřední jazyky EU a spolu s vahami zveřejňuje data a vyhodnocení. Pod tím program Komise pro AI gigafactories mobilizuje přes nástroj InvestAI 20 miliard eur na trénovací kapacitu, kterou tyto modely potřebují.