KI-API-Preise pro Token: was du wirklich zahlst
Was eine Million Tokens kostet, warum Output teurer ist als Input und wann ein Abo günstiger ist als die Abrechnung pro Token. Echte Euro-Preise, ohne Sternchen.
Abrechnung pro Token heißt: Du bezahlst Text nach Menge, und zwar zu zwei verschiedenen Preisen. Einer gilt für die Tokens, die du sendest, ein höherer für die Tokens, die das Modell zurückschreibt. Bei Union AI reicht das von 0,40 € pro Million Input-Tokens auf der günstigsten Stufe bis 12 € pro Million Output-Tokens auf der stärksten, jeweils ohne MwSt. An der API hängt kein Abo, kein monatliches Minimum und keine Rechnung, die du nicht selbst ausgelöst hast.
Das Problem: Eine Million Tokens ist keine Einheit, die man sich vorstellen kann. Dieser Beitrag übersetzt sie in Zahlen, die greifbar sind, mit denselben Preisen, nach denen unser Router abrechnet.
Was kostet eine Million Tokens?
Hier ist die ganze Preisliste. Vier Stufen, je zwei Preise, in Euro, ohne MwSt.
| Stufe | Geeignet für | Input pro 1 Mio. | Output pro 1 Mio. | Kontext |
|---|---|---|---|---|
| Lite | Klassifizieren, Extrahieren, kurze Antworten | 0,40 € | 1,60 € | 131.000 Tokens |
| Standard | Das Arbeitspferd: Chat und der Großteil des API-Traffics | 0,70 € | 3,50 € | 262.000 Tokens |
| Langer Kontext | Ganze Akten, Verträge, Codebasen | 1,00 € | 2,00 € | 1 Mio. Tokens |
| Pro | Anspruchsvolles Reasoning, Agenten, komplexer Code | 4,00 € | 12,00 € | 1 Mio. Tokens |
Zwei Dinge in dieser Tabelle überraschen viele. Die Stufe Langer Kontext ist beim Output günstiger als das Arbeitspferd, denn ein Modell, das für eine Million Tokens Input gebaut ist, ist nicht automatisch das stärkste im Schlussfolgern. Und zwischen der günstigsten und der teuersten Stufe liegt der Faktor zehn. Die Wahl der Stufe bewegt deine Rechnung also weit stärker, als es Prompt-Tuning je tun wird.
Die vollständige Tabelle, samt Rechner und Vergleich mit den amerikanischen Anbietern zu deren Listenpreisen, steht auf der Preisseite. Welches Open-Weight-Modell hinter welcher Stufe steckt und unter welcher Lizenz, steht auf der Seite zur KI-Transparenz.
Wie viele Tokens sind eine Seite, eine Nachricht, eine Codebasis?
Ein Token ist ein Stück Text, das das Modell liest oder schreibt, meist ein häufiges Wort oder ein Teil davon. Die Faustregel für Englisch lautet: tausend Tokens für etwa 750 Wörter. Andere Sprachen lassen sich weniger effizient in Tokens zerlegen, derselbe Text auf Niederländisch, Finnisch oder Polnisch kostet deshalb etwas mehr.
Ein paar Anhaltspunkte, die die Abstraktion greifbar machen:
- Eine kurze Frage mit einem Absatz als Antwort: rund 300 Tokens hinein, 200 heraus.
- Eine mittlere Nachricht, etwas Kontext und eine ausgearbeitete Antwort: etwa 900 hinein und 500 heraus. Diese Annahme steckt hinter jeder Zahl auf unserer Preisseite.
- Ein Vertrag mit 40 Seiten: irgendwo um 20.000 Input-Tokens. Ihn auf der Standard-Stufe zusammenzufassen, kostet einen Bruchteil eines Cents.
- Eine mittelgroße Codebasis, sagen wir 5.000 Zeilen: passt bequem in das Fenster von 262.000 Tokens der Standard-Stufe und kommt nicht annähernd an die Million der Stufe Langer Kontext heran.
Schick die mittlere Nachricht durch die Standard-Stufe, und tausend davon kosten 2,38 €. Diese Zahl solltest du dir merken, denn sie verschiebt die ganze Frage: Für die meisten Teams ist das Modell nicht der teure Teil des Produkts.
Warum ist Output teurer als Input?
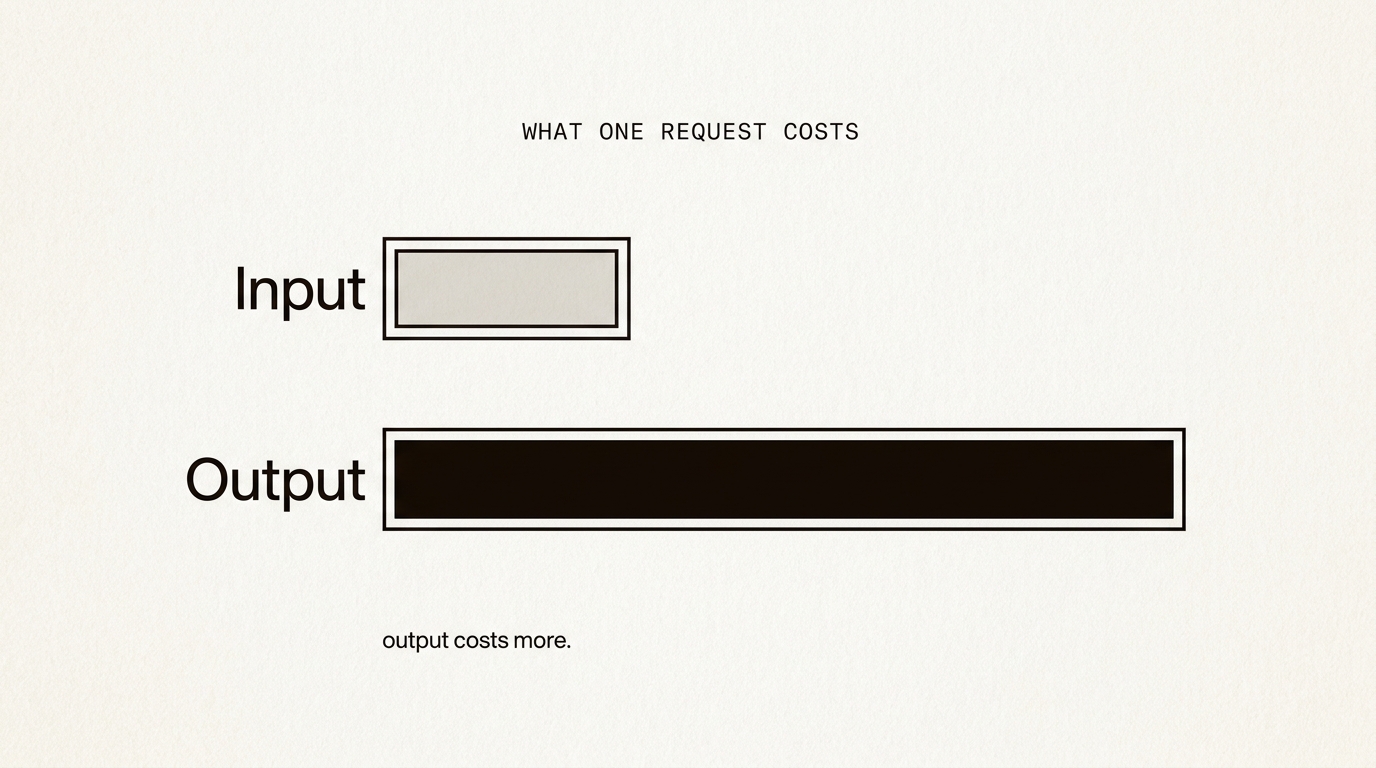
Weil Schreiben langsamer ist als Lesen. Input-Tokens laufen in einem parallelen Durchgang durch das Modell, ein langer Prompt kostet also ungefähr das, was seine Länge vermuten lässt, und nicht mehr. Output-Tokens kommen einzeln heraus, jedes abhängig vom vorherigen, und die Hardware ist die ganze Sequenz lang belegt. Der höhere Output-Preis ist genau diese serielle Zeit.
Daraus folgt eine Gewohnheit, die sich lohnt: Begrenze den Output, nicht den Input. Ein ganzes Dokument in den Prompt zu kopieren, ist meist günstig. Eine Antwort mit tausend Wörtern anzufordern, wenn hundert reichen würden, ist das, was wirklich auf der Rechnung auftaucht. max_tokens zu setzen, ist die wirksamste Kostenkontrolle der API, und sie kostet eine Zeile.
Chat-Abo
13,00 €
13 € im Monat, 2.000 Nachrichten auf dieser Stufe inklusive, der Rest aus dem Guthaben.
API, pro Token
4,76 €
0,70 € Input und 3,50 € Output pro Million Tokens, keine Fixkosten.
Hier ist die API günstiger, um 8,24 € im Monat.
Diese mittlere Nachricht hat 900 Tokens Input und 500 Output, dieselben Annahmen wie auf der Preisseite. Beide Beträge verstehen sich ohne MwSt., und der Vergleich betrifft nur das Geld: Das Abo bringt auch eine Oberfläche, Anhänge und geteilte Unterhaltungen mit, reine Tokens nicht.
Ist Pay-as-you-go günstiger als ein Abo?
Bei geringem Volumen fast immer. Ein paar hundert Nachrichten im Monat über die API kosten auf der Standard-Stufe deutlich weniger als einen Euro, während jedes Abo denselben festen Betrag verlangt, ob du es nutzt oder nicht. Unter tausend Nachrichten im Monat ist die Abrechnung pro Token nicht einmal ein fairer Wettkampf.
In drei Fällen dreht sich das Bild, und der Vergleich oben lässt dich sie selbst finden:
- Lange Nachrichten. Ein Prompt mit viertausend Tokens und einer langen Antwort kostet ein Mehrfaches einer mittleren Nachricht, und der feste Betrag wirkt plötzlich nicht mehr albern.
- Die teure Stufe. Eine Pro-Antwort kostet aus dem Guthaben etwa das Vierfache einer Standard-Antwort und zählt im Chat-Abo als fünf Nachrichten gegen das monatliche Kontingent.
- Du willst das Produkt, nicht die Leitung. Unser Chat-Abo kostet 13 € im Monat, oder 11 € im Monat bei jährlicher Zahlung, für eine Oberfläche, Anhänge, lange Dokumente und geteilte Unterhaltungen. Das selbst auf der API nachzubauen, kostet dich schon am ersten Nachmittag mehr als 13 € an eigener Zeit.
Ein Abo ist eine Wette darauf, wie teuer deine durchschnittliche Nachricht am Ende ist. Abrechnung pro Token ist die Weigerung zu wetten.
Keines der beiden Modelle ist ehrlicher als das andere. Ehrlich ist ein Preis dann, wenn du ihn vorhersagen kannst, bevor du dich festlegst. Deshalb nennt unser Rechner seine Annahmen, statt einen freundlich aussehenden Monatsbetrag hinzustellen.
Was die Abrechnung pro Token verschweigt
Vier Dinge, durch die echte Rechnungen von der Rechnung auf dem Papier abweichen. Keines davon ist ein Trick, und alle erwischen die Leute trotzdem.
Der Gesprächsverlauf wird bei jeder Runde neu gesendet
Ein API-Aufruf ist zustandslos. Runde zehn einer Unterhaltung schickt die Runden eins bis neun mit, die Input-Tokens wachsen also mit der Länge des Threads. Ein langer Chat kann mehr dafür ausgeben, seinen eigenen Verlauf erneut zu lesen, als für irgendetwas Neues. Alte Runden zu kürzen oder zusammenzufassen, ist keine verfrühte Optimierung, sondern der wichtigste Hebel.
Wiederholungen und Agenten vervielfachen die Anfragen
Eine Nutzeraktion in einer Agenten-Schleife kann zwanzig Modellaufrufe bedeuten. Multipliziere die Kosten pro Anfrage mit der Schleife, nicht mit dem Nutzer. Prüfe dann, was passiert, wenn die Schleife nicht endet. Dafür sind die Obergrenzen im nächsten Abschnitt da.
Die Schaufensterpreise sind nicht die ganze Preisliste
Anbieter veröffentlichen Rabatte für gecachten Input, Batch-Jobs und zugesagte Ausgaben. Die sind echt, und sie bedeuten, dass ein Vergleich nur hält, wenn beide Seiten zum Standardpreis angegeben sind. Unsere Vergleichstabelle nutzt aus genau diesem Grund auf beiden Seiten Listenpreise, mit dem Wechselkurs und dem Datum, an dem er abgelesen wurde, darunter. Dieselben Zahlen gehen wir Anbieter für Anbieter in europäische KI-Anbieter im Vergleich durch.
Auch gescheiterte Arbeit kostet, außer jemand entscheidet es anders
Liefert ein Modell etwas Unbrauchbares, haben die meisten Zähler die Tokens schon mitgezählt. Wir sehen das anders: Eine Anfrage, die keine brauchbare Antwort geliefert hat, zieht nichts von deinem Guthaben ab, und eine umgeleitete Anfrage, die auf einem schwächeren Modell landet, wird zum niedrigeren der beiden Preise abgerechnet. Die Dokumentation listet die Header auf, an denen du erkennst, was davon passiert ist.
Zahle ich MwSt. auf vorausbezahltes KI-Guthaben?
Das hängt davon ab, wer du bist und wo. Bist du ein Unternehmen in einem anderen EU-Land mit gültiger USt-IdNr., gilt das Reverse-Charge-Verfahren: Wir schlagen keine MwSt. auf, und du führst sie selbst ab. Der Leitfaden der Europäischen Kommission zur grenzüberschreitenden Mehrwertsteuer auf Dienstleistungen sagt es klar: Kunden zahlen die Mehrwertsteuer auf erhaltene Dienstleistungen im Reverse-Charge-Verfahren zum Satz ihres eigenen Landes.
Hast du keine gültige USt-IdNr. oder kaufst du als Verbraucher, fällt die MwSt. zum Satz des Landes an, in dem du bist. Jeder Preis auf dieser Website ist ohne MwSt. angegeben, und auf deiner Rechnung steht, welche der beiden Varianten angewendet wurde.
Wie du verhinderst, dass deine Token-Rechnung davonläuft
Das Problem ist nie der Preis pro Million. Es ist eine Schleife, ein geleakter Schlüssel oder ein Job, der das ganze Wochenende lief. Fünf Schutzmaßnahmen, in der Reihenfolge, in der du sie einrichten solltest:
- Setz eine Obergrenze pro Schlüssel, in Euro, pro Tag und pro Monat. Ein Schlüssel ohne Obergrenze ist ein Blankoscheck.
- Setz
max_tokensbei jedem Aufruf. Siehe oben beim Output-Preis. - Lies
X-EU-Cost-EURin der Antwort. Jede Anfrage sagt dir, was sie von deinem Guthaben abgezogen hat, deine eigenen Logs beantworten die Kostenfrage also ohne Dashboard. - Halte das Guthaben klein. Vorausbezahltes Guthaben hat eine harte Untergrenze bei null, und das ist gewollt. Eine Aufladung über 10 € kann nicht zu einer Überraschung über 4.000 € werden.
- Lass die Anomalieprüfung ihre Arbeit machen. Sehen wir innerhalb einer Stunde mehr als das Zehnfache deines Wochendurchschnitts, pausieren wir den Schlüssel und schicken dir eine E-Mail. Neue Konten sind in den ersten 48 Stunden auf 25 € pro Tag begrenzt, egal wie hoch das Guthaben ist.
Die letzte Maßnahme kostet gelegentlich einen Fehlalarm. Wir halten einen unterbrochenen Batch-Job für das bessere Ergebnis als ein leeres Konto, und du kannst die Grenze selbst aufheben, sobald du weißt, dass der Traffic von dir kommt.
Was der Einstieg kostet
Zehn API-Anfragen sind kostenlos, die Mindestaufladung beträgt 10 €, und Guthaben bleibt 24 Monate gültig. Um den Chat auszuprobieren, brauchst du keine Karte: Du bekommst 5 kostenlose Nachrichten, bevor irgendetwas von dir verlangt wird.
Eine bestehende Integration umzuziehen, um diese Zahlen mit deinem eigenen Traffic zu sehen, braucht einen Schlüssel, eine Base-URL und einen Stufennamen. Darum geht es in Wechseln in drei Zeilen.
Das ist die ganze kaufmännische Seite. Wenn du die andere Hälfte willst, also wo diese Tokens verarbeitet werden und wer sie unterwegs lesen kann, verfolgt der Begleitbeitrag zur Datenresidenz von KI in der EU dieselbe Anfrage Station für Station, und europäische souveräne KI zeigt, was das Wort souverän wert ist, wenn man es auseinandernimmt.
Häufige Fragen
Wie viel kostet eine Million Tokens?
Das hängt vom Modell ab und davon, ob die Tokens hinein- oder herausgehen. Bei Union AI kostet eine Million Input-Tokens je nach Stufe zwischen 0,40 und 4 Euro, eine Million Output-Tokens zwischen 1,60 und 12 Euro, jeweils ohne MwSt. Output ist bei jedem Anbieter die teurere Hälfte.
Was ist ein Token bei einer KI-API?
Ein Token ist ein Stück Text, das das Modell liest oder schreibt, meist ein häufiges Wort oder ein Teil davon. Als Faustregel für Englisch entsprechen tausend Tokens etwa 750 Wörtern, eine A4-Seite Fließtext liegt also bei rund 500 Tokens. Abgerechnet werden die Tokens, die du sendest, und die Tokens, die das Modell erzeugt, getrennt.
Warum ist Output teurer als Input?
Weil Text zu erzeugen langsamer ist, als ihn zu lesen. Input-Tokens lassen sich in einem parallelen Durchlauf verarbeiten, Output-Tokens entstehen dagegen nacheinander, und jedes wartet auf das vorherige. Diesen Unterschied in der Rechenzeit bezahlt der höhere Output-Preis.
Ist Pay-as-you-go günstiger als ein KI-Abo?
Bei geringem Volumen fast immer. Ein paar hundert Nachrichten im Monat über eine API kosten oft weniger als einen Euro, während ein Abo einen festen Betrag verlangt, ob du es nutzt oder nicht. Das Abo gewinnt, wenn deine Nachrichten lang sind, du das teure Modell nutzt oder eine fertige Oberfläche statt einer API willst.
Wie viele Tokens hat ein Dokument mit 40 Seiten?
Rund 20.000 Input-Tokens für 40 Seiten normalen Fließtext, gerechnet mit etwa 750 Wörtern pro tausend Tokens. Auf einer mittleren Stufe kostet das Lesen einen Bruchteil eines Cents. Deshalb ist langer Input selten der Grund für eine hohe KI-Rechnung.
Warum ist meine KI-Rechnung schneller gewachsen als meine Nutzung?
Fast immer, weil der Gesprächsverlauf bei jeder Runde erneut gesendet wird. Ein API-Aufruf ist zustandslos, Runde zehn trägt also die Runden eins bis neun mit sich, und die Input-Tokens wachsen mit der Länge des Threads statt mit der Zahl der Nutzer. Agenten-Schleifen tun dasselbe und machen aus einer Nutzeraktion zwanzig abgerechnete Anfragen.
Wie schätze ich LLM-Kosten, bevor ich etwas baue?
Nimm eine realistische Anfrage, zähle Input- und Output-Tokens getrennt und multipliziere mit dem erwarteten Volumen zu den Preisen pro Million des Anbieters. Verdopple dann den Output-Wert als Sicherheitspuffer und rechne alles dazu, was dein Design erneut sendet, etwa den Chatverlauf oder abgerufene Dokumente. Diese Schätzung trifft meist die richtige Größenordnung, und mehr braucht eine Entscheidung zum Bauen nicht.