Souveräne KI in Europa: Was sie praktisch bedeutet
Souveräne KI sind vier getrennte Fragen: Gebäude, Betreiber, Gewichte und Werte. Was Europa heute beantworten kann und was du noch dieses Quartal tun kannst.
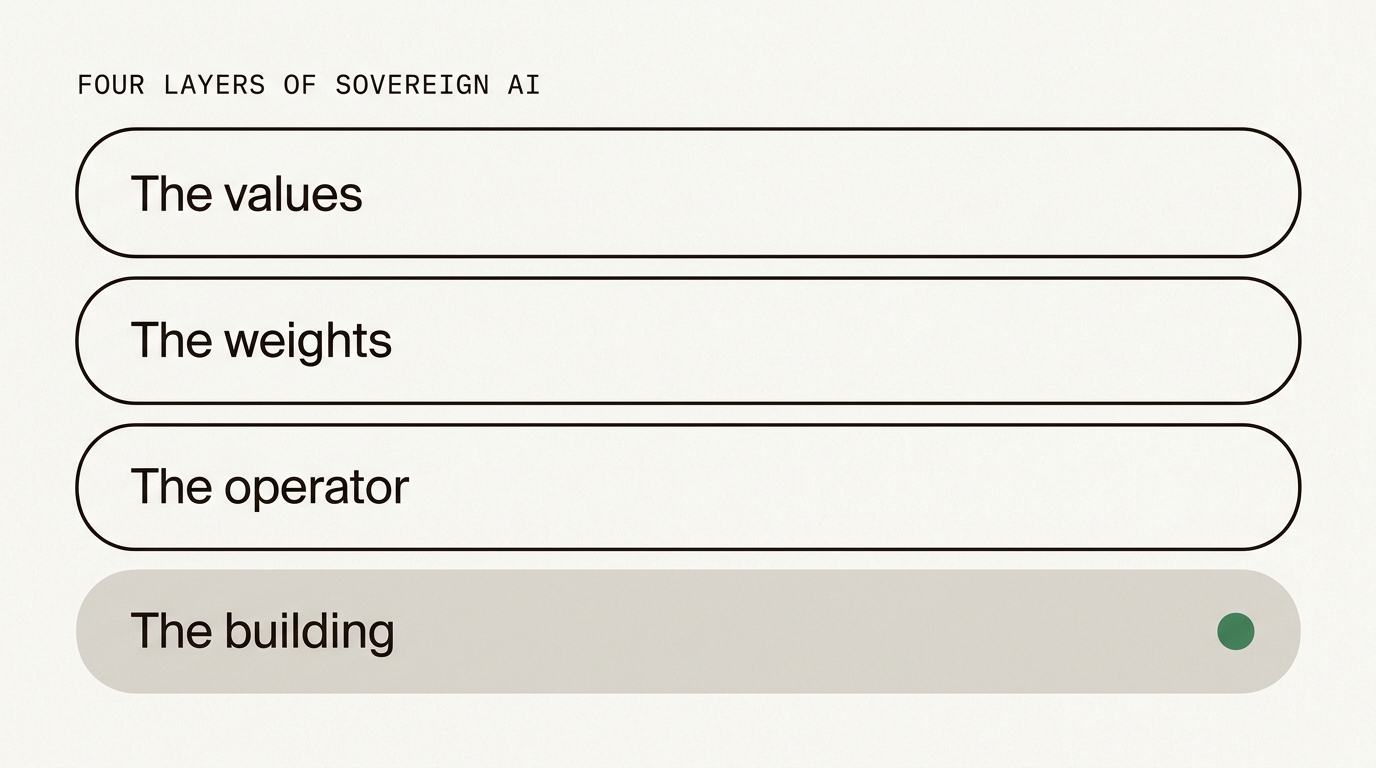
Souveräne KI ist keine einzelne Eigenschaft. Es sind vier Fragen, die aufeinander aufbauen: wo die Hardware steht, welcher Staat das Unternehmen zwingen kann, das sie betreibt, wer das Modell trainiert hat und wessen Annahmen das Modell mit sich trägt. Europa kann die erste gut beantworten, die zweite mit Einschränkungen und die dritte und vierte nur teilweise. Wer dir alle vier in einem Wort verkauft, verkauft dir ein Vorhaben.
Das sollte man klar sagen, bevor irgendein Produkt ins Gespräch kommt, auch unseres. Die nützliche Version dieser Debatte lautet nicht „europäisch oder amerikanisch“. Sie lautet: Welche Ebene des Stacks braucht genau diese Anwendung wirklich, und was kostet es, diese Ebene zu verlegen?
Was souveräne KI wirklich bedeutet
Das Wort stammt aus der Debatte um Rechenkapazität, wo es eine präzise Bedeutung hatte: Ein Staat soll kritische Systeme betreiben können, ohne einen anderen Staat um Erlaubnis zu fragen. Auf KI übertragen, dehnte es sich auf alles aus, von der Postleitzahl des Rechenzentrums bis zur politischen Neigung eines Chatbots, und verlor unterwegs den größten Teil seines Nutzens.
Zerlegt man es wieder in seine Teile, wird jeder davon prüfbar.
Souveränität ist kein Siegel auf einer Landingpage. Es sind vier Fragen mit vier verschiedenen Antworten, und ehrliche Anbieter sagen dir, welche davon sie beantworten.
Das Gebäude ist Geografie: In welchem Land steht die Hardware? Der Betreiber ist Gerichtsbarkeit: Welches Rechtssystem bindet das Unternehmen, das diese Hardware betreibt? Die Gewichte sind Herkunft: Wer hat das Modell trainiert, mit welchen Daten, unter welcher Lizenz? Die Werte sind Verhalten: Was sagt das Modell, was verweigert es, und was liegt es über deinen Teil der Welt stillschweigend falsch?
Wer liefert welche Ebene heute in Europa?
| Ebene | Die Frage | Europa heute |
|---|---|---|
| Das Gebäude | Wo steht die Hardware? | Gelöst. Europäische Kapazität gibt es wirklich, und sie ist buchbar |
| Der Betreiber | Welcher Staat kann den Betreiber zwingen? | Für Inferenz verfügbar, schwieriger bei Hosting, Datenbanken und Zahlungen |
| Die Gewichte | Wer hat das Modell trainiert? | Dünn, aber im Kommen, die fehlende Rechenkapazität wird gerade aufgebaut |
| Die Werte | Was wird das Modell sagen und verweigern? | Teilweise, und meist über Dokumentation statt über Training |
Je weiter du nach oben gehst, desto schwieriger werden die Ebenen, und desto teurer wird jede davon. Europäische Rechenkapazität zu mieten, ist eine Beschaffungsentscheidung. Ein konkurrenzfähiges Frontier-Modell in Europa zu trainieren, ist ein mehrjähriges Industrieprojekt, und genau dafür ist die aktuelle Welle an EU-Förderung da.
Wo steht die Hardware physisch?
- Was Europa heute liefern kann
- Gelöst. Europäische Rechenzentrumskapazität gibt es wirklich, sie ist buchbar und wächst.
- Was Union AI tut
- Die gesamte KI-Inferenz läuft auf Infrastruktur in der Europäischen Union.
Ein grüner Punkt von vier. Wer heute alle vier behauptet, beschreibt ein Vorhaben, keinen Stack, den du kaufen kannst.
Gibt es europäische LLMs, die sich lohnen?
Ja, und ehrlich betrachtet ist das ein junges Feld, kein fertiges. Es teilt sich in zwei Arten von Anstrengung.
Die erste ist kommerziell. Europäische Labore veröffentlichen Open-Weight-Modelle, die du herunterladen und selbst betreiben kannst, und ihre kleineren Modelle sind für die tägliche Arbeit wirklich konkurrenzfähig. Das ist der Teil des europäischen Stacks, der heute schon im Produktivbetrieb funktioniert.
Die zweite ist öffentlich. OpenEuroLLM ist ein Konsortium europäischer Universitäten, HPC-Zentren und Unternehmen, finanziert über das Programm Digitales Europa, das offene Basismodelle für die Amtssprachen der EU baut und Daten, Code und Evaluierung zusammen mit den Gewichten veröffentlicht. Dieser letzte Teil zählt mehr als die Benchmark-Werte: Ein Modell mit öffentlichen Trainingsdaten und Evaluierungen ist ein Modell, das du prüfen kannst, und an der Spitze ist heute fast nichts prüfbar.
Unter beidem liegt die Rechenkapazität. Das Programm der Kommission für KI-Gigafabriken mobilisiert über die Fazilität InvestAI 20 Milliarden € für großskalige Trainingskapazität in Europa. Die informelle Interessenbekundung brachte 77 Vorschläge aus 16 Mitgliedstaaten für 60 Standorte, der Bau des ersten Standorts wird ab 2027 erwartet. Ob das die Lücke bei den Fähigkeiten schließt, ist offen. Es heißt aber, dass die Antwort 2029 nicht die von heute sein wird, und das ist ein Grund, deinen Stack portabel zu halten, statt zu warten.
Kann ein Modell mit europäischen Werten trainiert werden?
Teilweise, und die Formulierung verdient mehr Skepsis, als sie meist bekommt. „Mit europäischen Werten trainiert“ erledigt drei verschiedene Aufgaben, und nur zwei davon lassen sich prüfen.
Sprache ist ein Wert, und sie ist messbar
Ein Modell, das Niederländisch, Finnisch, Griechisch und Portugiesisch so gut beherrscht wie Englisch, ist für europäische Nutzer ein anderes Produkt als eines, das diese Sprachen nebenbei mitnimmt. Die Sprachabdeckung lässt sich an einem Nachmittag testen: Lass deine eigenen Prompts in deinen eigenen Sprachen laufen und vergleiche. Das ist der nützlichste einzelne Test in der ganzen Souveränitätsdebatte, und fast niemand macht ihn vor dem Kauf.
Das Ablehnungsverhalten verrät das Training
Manche Open-Weight-Modelle werden unter Rechtssystemen mit eigenen Empfindlichkeiten trainiert, und sie weichen Sachfragen zu Politik oder Geschichte aus, die ein europäischer Nutzer für völlig normal hält. Wir behandeln das als Mangel, nicht als Sicherheitsfunktion. Erkennt unser System diese Art von Ablehnung im ersten Satz einer Antwort, bricht es die Antwort ab und stellt die Frage erneut an ein Modell ohne diesen blinden Fleck, höchstens einmal pro Anfrage, und sagt dir im Header X-EU-Routed, dass das passiert ist. Was wir nicht tun: echte Sicherheitsablehnungen umgehen. Die bleiben abgelehnt, denn so lange umzuleiten, bis ein Modell mitspielt, ist ein automatisierter Jailbreak.
Alles andere ist Dokumentation, nicht Training
Der Rest dessen, was Leute mit Werten meinen, dass ein Modell fair, ausgewogen und angemessen ist, lässt sich auf einer Marketingseite nicht überprüfen. Überprüfen kannst du, ob der Anbieter Modell, Lizenz, System-Prompt und gemessene Ablehnungsrate veröffentlicht. Wir veröffentlichen alle vier auf unserer Seite zur KI-Transparenz, auch die Teile, bei denen wir schlechter aussehen.
Braucht Datensicherheit ein europäisches Modell?
Nein, und wer beides vermischt, zahlt dafür echtes Geld. Wo ein Modell trainiert wurde und wo dein Prompt verarbeitet wird, sind voneinander unabhängige Tatsachen.
Gewichte sind eine Datei. Lade ein Open-Weight-Modell herunter, betreibe es auf europäischer Hardware, und dein Prompt geht an diese Hardware und kommt zurück, egal wer das Modell trainiert hat. Mit den Gewichten reist Verhalten, kein Datenfluss. Deshalb kann unser Stack offen damit umgehen, dass er überwiegend nichteuropäische Modelle betreibt und trotzdem jede Anfrage in der Europäischen Union verarbeitet, und deshalb zählt für den Datenschutz der Weg einer Anfrage mehr als die Herkunftsgeschichte des Modells.
Die vier Fragen zur Datensicherheit, die du jedem Anbieter stellen solltest, ob europäisch oder nicht: Wo wird die Inferenz verarbeitet, wie lange werden Prompts aufbewahrt, werden sie zum Training genutzt, und welche Beteiligten in der Kette haben eine Muttergesellschaft außerhalb der EU? Unsere Antworten stehen auf der Seite mit den Unterauftragsverarbeitern, auch die unbequemen.
Was du dieses Quartal konkret tun kannst
Souveränität als Kaufentscheidung scheitert, denn nichts auf dem Markt erfüllt alle vier Ebenen. Souveränität als Folge kleiner Schritte funktioniert. Grob nach Nutzen sortiert:
- Ordne erst die Anwendungen ein, dann die Anbieter. Die meisten Teams haben einen kleinen Teil wirklich sensibler Daten und eine große Mehrheit gewöhnlicher. Das Verhältnis zu kennen, ändert, für welche Abwägungen es sich lohnt zu zahlen.
- Verlege zuerst den sensiblen Teil. Kundenverträge, Personalakten, Patientennotizen, unveröffentlichter Code. Das Zusammenfassen öffentlicher Webseiten lässt du, wo es ist.
- Verlange die Liste der Unterauftragsverarbeiter und die Trainingsklausel schriftlich. Kein Vertriebsgespräch. Eine Liste mit Regionen und juristischen Personen, dazu eine Suche nach dem Wort „train“ in den Bedingungen.
- Halte die Schnittstelle langweilig. Eine OpenAI-kompatible API ist mehr wert als jede Souveränitätsbehauptung, weil sie einen Umzug billig macht. Portabilität ist das einzige Druckmittel, das übersteht, wenn ein Anbieter seine Meinung ändert. Unsere ist in der API-Referenz dokumentiert, und was ein Wechsel tatsächlich bedeutet, steht in Wechseln in drei Zeilen.
- Protokolliere Nachweise pro Anfrage. Ein Header, der Stufe, Token-Zahlen und Kosten nennt, macht aus einer Behauptung einen Prüfpfad.
- Wiederhole den Test in sechs Monaten. Die europäische Modelllandschaft bewegt sich schneller als jeder Beschaffungszyklus. Annahmen vom letzten Jahr sind veraltet.
Nichts davon erfordert einen Neubau, und alles davon übersteht jede Richtung, in die sich der Markt entwickelt.
Wo wir hineinpassen und wo nicht
Union AI ist ein europäischer Dienst, der Open-Weight-Modelle betreibt, mit der gesamten KI-Inferenz auf Infrastruktur in der Europäischen Union, im Voraus bezahlt in Euro und abgerechnet pro Token. Wir decken die unterste Ebene vollständig ab, den Großteil der Betreiberebene, und über die beiden darüber sprechen wir offen.
Unsere Modelle sind Open Weight unter Apache 2.0 und MIT, und die meisten davon wurden nicht in Europa trainiert. Das einzige in Europa trainierte Modell in unserem Stack ist heute das Mistral-Modell, auf das wir in der günstigsten Stufe zurückfallen, wenn das primäre ausfällt. Wir schreiben diesen Satz lieber hin, als das Wort souverän die Arbeit für uns machen zu lassen.
Wie das im Vergleich zu den drei anderen Wegen abschneidet, in Europa KI einzukaufen, einschließlich der Zeilen, in denen wir verlieren, steht in Europäische KI-Anbieter im Vergleich.
Das Angebot ist also mit Absicht schmal. Willst du, dass deine Prompts in Europa verarbeitet werden, bei einem europäischen Anbieter, auf Modellen mit dokumentiertem Verhalten und mit einer vorhersehbaren Rechnung, dann gibt es das heute, und du kannst diese Woche damit anfangen. Willst du ein europäisches Frontier-Modell, trainiert auf europäischen Daten, dann wird das gerade gebaut, mit öffentlichem Geld und einem veröffentlichten Zeitplan, und weder wir noch sonst jemand kann es dir schon verkaufen.
Häufige Fragen
Was ist souveräne KI?
Souveräne KI ist die Idee, dass ein Land oder eine Union KI-Systeme betreiben kann, die es selbst kontrolliert, zu seinen eigenen Bedingungen. In der Praxis zerfällt das in vier Fragen: wo die Hardware steht, welcher Staat den Betreiber zwingen kann, wer das Modell trainiert hat und wessen Werte das Modell widerspiegelt. Die meisten Anbieter beantworten eine der vier und verwenden das Wort für alle.
Brauche ich ein europäisches LLM, um den AI Act einzuhalten?
Nein. Der AI Act regelt, wie KI-Systeme gebaut, dokumentiert und Menschen gegenüber dargestellt werden, nicht, wo das Modell trainiert wurde. Ein amerikanisches oder chinesisches Open-Weight-Modell lässt sich regelkonform einsetzen, ein europäisches Modell auch regelwidrig. Bei der Compliance geht es um deine Pflichten als Anbieter oder Betreiber, nicht um den Pass der Gewichte.
Sind Open-Weight-Modelle dasselbe wie Open Source?
Nein, und der Unterschied zählt. Open Weight heißt, dass du das Modell herunterladen und selbst betreiben kannst, meist unter einer Lizenz wie Apache 2.0 oder MIT. Open Source im umfassenderen Sinn hieße außerdem veröffentlichte Trainingsdaten und reproduzierbarer Trainingscode, und das liefern die meisten Open-Weight-Veröffentlichungen nicht.
Kann ich ein chinesisches Open-Weight-Modell nutzen und die Daten trotzdem in Europa halten?
Ja. Gewichte sind eine Datei. Sobald du ein Modell herunterlädst und auf europäischer Infrastruktur betreibst, gehen deine Prompts an diese Hardware und nirgendwo sonst hin, egal wer das Modell trainiert hat. Was mit den Gewichten mitreist, sind nicht deine Daten, sondern das Verhalten des Modells, einschließlich der Themen, denen es antrainiert ausweicht.
Sind meine Daten sicher, wenn ein Modell in Europa läuft?
Damit fällt eine Art von Risiko weg, andere bleiben. Es heißt, dass deine Prompts auf europäischer Infrastruktur verarbeitet werden, statt ins Ausland zu gehen, sagt aber nichts über Aufbewahrung, Training mit deinen Eingaben, Zugriffskontrollen oder darüber, ob der Betreiber eine Muttergesellschaft außerhalb der EU hat. Frag alle vier Punkte einzeln ab.
Was bedeutet es, wenn ein Modell mit europäischen Werten trainiert ist?
In der Praxis drei prüfbare Dinge: dass es europäische Sprachen gut beherrscht, dass es Sachfragen zu Politik und Geschichte beantwortet, statt ihnen auszuweichen, und dass seine Trainingsdaten und sein Ablehnungsverhalten dokumentiert sind. Überprüfen lässt sich so ein Slogan nicht, behandle ihn also als eine Reihe von Tests, die du selbst durchführst, nicht als Etikett, dem du vertraust.
Welche EU-Projekte trainieren europäische Sprachmodelle?
OpenEuroLLM ist das sichtbarste: ein Konsortium europäischer Universitäten, HPC-Zentren und Unternehmen, finanziert über das Programm Digitales Europa, das offene Modelle für die Amtssprachen der EU baut und Daten und Evaluierung zusammen mit den Gewichten veröffentlicht. Darunter mobilisiert das Programm der Kommission für KI-Gigafabriken über die Fazilität InvestAI 20 Milliarden Euro für die Trainingskapazität, die diese Modelle brauchen.