Dokąd trafiają twoje prompty: AI i dane w UE
Co naprawdę oznacza lokalizacja danych AI w UE (data residency), czym różni się od suwerenności i jak sprawdzić, gdzie dostawca AI przetwarza twoje prompty.
Twój prompt trafia do maszyny w budynku, który ma adres. Lokalizacja danych AI w UE (data residency) oznacza, że ten budynek stoi w Unii Europejskiej, i to jest fakt, który da się sprawdzić. To nie to samo co suwerenność, która dotyczy tego, który rząd może zmusić do czegoś firmę będącą właścicielem maszyny. Większość dostawców chętnie pozwala ci te dwie rzeczy pomylić.
Union AI uruchamia całą inferencję AI na infrastrukturze w Unii Europejskiej. Nasz hosting, nasza baza danych i obsługa płatności angażują firmy ze spółkami matkami w Stanach Zjednoczonych, dlatego nie mówimy ci, że żadne dane nigdy nie opuszczają UE. To zdanie jest sednem tego tekstu: lokalizacja danych to realna, przydatna właściwość, ale kończy się dużo wcześniej, niż sugeruje słowo „suwerenny”.
Czy moje dane opuszczają UE, gdy korzystam z API AI?
Na to pytanie nie ma jednej odpowiedzi, bo „moje dane” to co najmniej cztery różne rzeczy, a każda podróżuje inaczej. Rozdzielenie ich to najszybszy sposób, żeby przebić się przez marketing.
| Dane | Czym są | Dokąd trafiają w Union AI |
|---|---|---|
| Prompt i odpowiedź | Tekst, który wysyłasz, i odpowiedź, którą pisze model | Przetwarzane w Unii Europejskiej, nigdy w USA ani w Chinach |
| Dane konta i użycia | Twoje konto, saldo, liczba tokenów, znaczniki czasu | Region w UE, prowadzony przez firmę ze spółką matką w USA |
| Dane rozliczeniowe | Imię i nazwisko, e-mail, numer VAT, dane płatności | Przetwarzanie w UE, spółka matka w USA |
| Ruch w drodze | Zaszyfrowane zapytanie w drodze do nas | Przez brzeg sieci (edge) Cloudflare w jego regionie UE |
Większość dostawców odpowiada pierwszym wierszem i na tym kończy. To najważniejszy wiersz, bo właśnie tam czytana jest twoja umowa z klientem, notatka o pacjencie czy nieopublikowany kod. To też wiersz, o którym najłatwiej mówić uczciwie, i dlatego milczenie o pozostałych trzech dużo mówi.
Lokalizacja danych, suwerenność i jurysdykcja to trzy różne rzeczy
Lokalizacja danych to geografia. Odpowiada na pytanie: w jakim kraju stoi sprzęt, który przechowuje lub przetwarza te dane? Da się to sprawdzić, a dostawca, który nie chce odpowiedzieć, coś ci w ten sposób mówi.
Jurysdykcja to zasięg prawa. Odpowiada na pytanie: sądy i organy którego państwa mogą wydać wiążący nakaz firmie, która kontroluje ten sprzęt? Jurysdykcja idzie za firmą, a nie za kablem.
Suwerenność danych to twierdzenie, że odpowiedzi na oba pytania wskazują to samo miejsce i że żaden zagraniczny organ nie dobierze się do twoich danych. To najmocniejsze z trzech twierdzeń i najczęściej wygłaszają je firmy, które nie są w stanie go obronić.
Region to nie to samo co jurysdykcja. Amerykańska spółka matka podlega CLOUD Act. Nie zmienia to niczego w tym, gdzie przetwarzane są twoje prompty, ale zmienia to, co ktokolwiek może ci o nich uczciwie obiecać.
Suwerenność w pełnym sensie ma więcej warstw niż te dwie, a tekst o europejskiej suwerennej AI rozbiera wszystkie cztery. To rozróżnienie jest powodem, dla którego nasza strona z podprocesorami wymienia trzy podmioty ze spółkami matkami w USA, zamiast chować je za europejską flagą. Lista, która pomija niewygodne wiersze, to nie przejrzystość, tylko reklama.
Czy amerykański CLOUD Act sięga danych przechowywanych w Europie?
Co do zasady tak. Clarifying Lawful Overseas Use of Data Act z 2018 roku pozwala organom Stanów Zjednoczonych żądać od dostawcy podlegającego jurysdykcji USA wydania danych, które posiada, przechowuje lub kontroluje, gdziekolwiek na świecie te dane leżą. Centrum danych we Frankfurcie nie wyprowadza danych poza ten zasięg, jeśli operator jest firmą amerykańską albo spółką zależną takiej firmy.
Co to oznacza w praktyce
Nie oznacza to, że ktoś czyta twoje prompty. Oznacza, że na pytanie prawne „kogo można zmusić do wydania tych danych?” odpowiedź jest inna niż na pytanie techniczne „gdzie to działa?”, i na oba warto odpowiedzieć, zanim cokolwiek podpiszesz.
Dla większości zespołów praktyczne skutki są wąskie. Jeśli przetwarzasz zwykłe dane biznesowe, ta ekspozycja to ryzyko do udokumentowania, a nie powód do paniki. Jeśli masz do czynienia z dokumentacją medyczną, aktami prawnymi, tajemnicami przedsiębiorstwa albo czymkolwiek, co obejmuje tajemnica zawodowa, odpowiedź na pytanie o jurysdykcję jest częścią twojej historii zgodności, a klienci prędzej czy później poproszą cię o nią na piśmie.
Co naprawdę zmniejsza ekspozycję
Cztery rzeczy, mniej więcej według siły działania:
- Mniej podmiotów z zagranicznymi spółkami matkami na drodze zapytania. Każdy, którego usuniesz, to jeden adresat nakazu mniej.
- Rozdzielenie treści i tożsamości. Nasz dostawca inferencji widzi prompt, ale nie wie, kto go wysłał. Nasza baza danych wie, kim jesteś, ale nie wie, o co pytasz.
- Krótka retencja. Danych, które już nie istnieją, nie da się wydać.
- Szyfrowanie z kluczami w twoich rękach, tam, gdzie pozwala na to charakter zadania. Inferencja to akurat zadanie, przy którym zwykle się tego nie da, bo model musi przeczytać tekst.
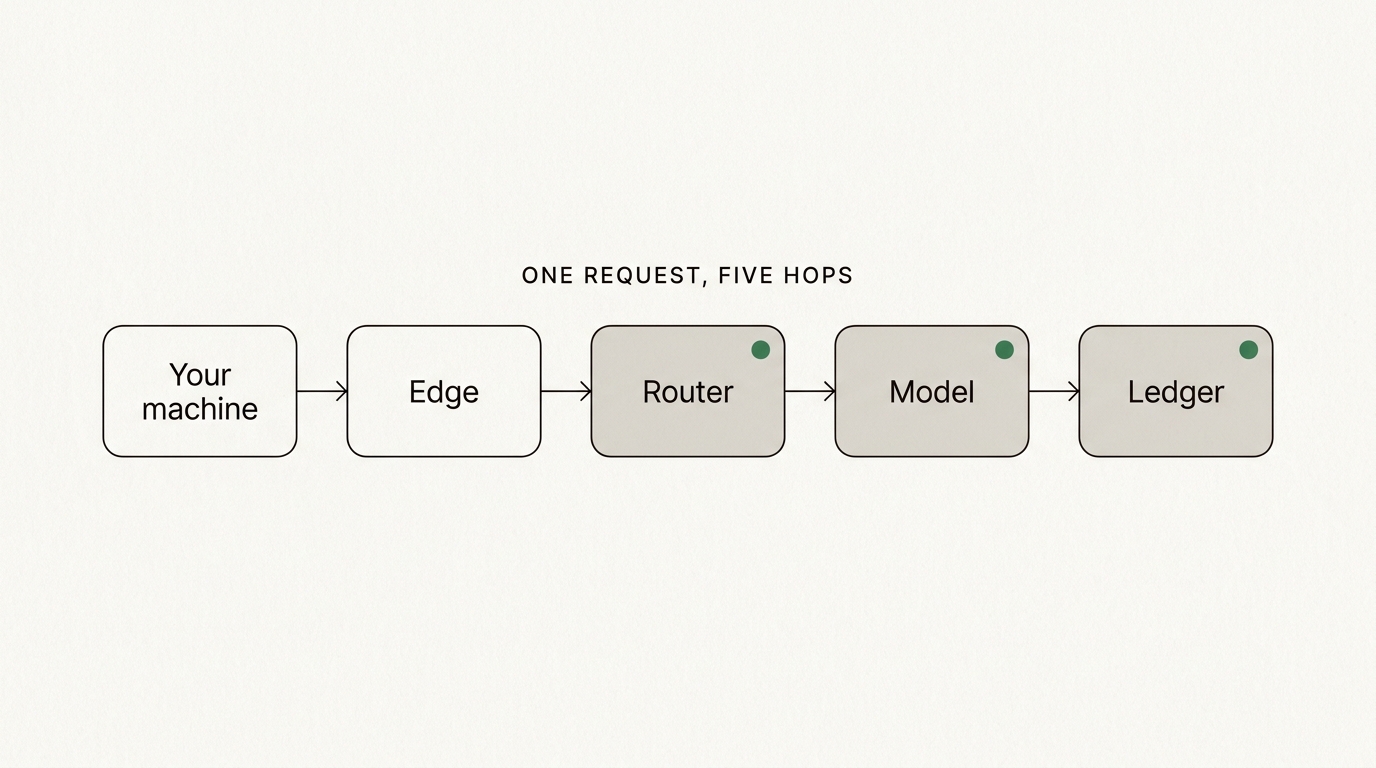
Twój komputer
Tam, gdzie jesteś
- Może odczytać
- Prompt otwartym tekstem, zanim cokolwiek go zaszyfruje.
- Nie może odczytać
- Nic. To jedyny etap, nad którym masz pełną kontrolę.
Każdy etap po twoim własnym komputerze działa w Unii Europejskiej i tylko model odczytuje twój prompt.
Które etapy zapytania mogą przeczytać twój prompt?
Pięć etapów i tylko jeden z nich czyta tekst. Przejście przez nie po kolei to różnica między deklaracją a zrozumieniem.
Twój komputer trzyma prompt otwartym tekstem, zanim cokolwiek go zaszyfruje. Na brzegu sieci (edge) kończy się połączenie TLS, więc twoje zapytanie przechodzi przez pamięć tamtej maszyny i nic nie jest tam zapisywane w cache'u. Nasz router widzi twój klucz, saldo i tier, o który prosisz, i przekazuje prompt dalej, niczego nie zapisując. Model czyta prompt i pisze odpowiedź na infrastrukturze w Unii Europejskiej, nie mając pojęcia, kim jesteś. Księga rozliczeń zapisuje liczbę tokenów, znacznik czasu i cenę, nigdy treść.
Brzeg sieci działa w regionie UE Cloudflare, więc etap, na którym kończy się połączenie TLS, również znajduje się w Unii Europejskiej. Pełna lista podmiotów, z ich regionami i podmiotem prawnym stojącym za każdym z nich, jest na stronie z podprocesorami.
Co według RODO musisz wiedzieć o swoim dostawcy AI?
Więcej, niż pyta większość kupujących. W świetle RODO zwykle to ty jesteś administratorem, a dostawca AI podmiotem przetwarzającym, co oznacza, że jesteś winien swoim użytkownikom odpowiedź na pytanie, kto przetwarza ich dane, gdzie i na jakiej podstawie prawnej. Wynikają z tego trzy konkretne rzeczy.
Potrzebujesz umowy powierzenia przetwarzania danych (DPA), która nazywa role i zabezpieczenia. Naszą publikujemy w całości na stronie DPA, a nie wysyłamy na prośbę po rozmowie z handlowcem. Potrzebujesz aktualnej listy podprocesorów z prawem do sprzeciwu, zanim dojdzie nowy podmiot. I musisz wiedzieć, czy prompty są używane do trenowania, bo to zmienia cel przetwarzania, a nie tylko ryzyko.
To, które twoje dane w ogóle mogą trafić do narzędzia AI, to osobne pytanie niż to, gdzie to narzędzie działa. Rozkładamy je na części, razem z polityką korzystania do skopiowania, w tekście czy ChatGPT jest zgodny z RODO dla danych firmowych.
Organy nadzorcze wciąż ustalają, jak RODO stosuje się do samych modeli. Opinia 28/2024 Europejskiej Rady Ochrony Danych w sprawie ochrony danych w modelach AI, przyjęta w grudniu 2024 roku, określa, kiedy model trenowany na danych osobowych można uznać za anonimowy i kiedy prawnie uzasadniony interes może być podstawą prawną. Jej powracająca odpowiedź brzmi: trzeba to oceniać indywidualnie w każdym przypadku. To mało satysfakcjonujące, ale trafne. Kto sprzedaje ci gwarancję zgodności w jednym zdaniu, sprzedaje ci bajkę.
Co zmieniło się 2 sierpnia 2026 w związku z AI Act
Obowiązki przejrzystości z art. 50 AI Act (unijnego aktu w sprawie sztucznej inteligencji, rozporządzenia (UE) 2024/1689) zaczęły obowiązywać 2 sierpnia 2026. Jeśli budujesz system, który rozmawia z ludźmi, masz teraz prawny obowiązek zadbać o to, żeby wiedzieli, że rozmawiają z maszyną.
Wytyczne Komisji Europejskiej dotyczące obowiązków przejrzystości z art. 50 mówią konkretnie, jak to zrobić: użytkownik musi się o tym dowiedzieć od początku pierwszej interakcji, w jasny i wyraźny sposób. Linijka ukryta w regulaminie się nie liczy. Etykieta, którą rozpozna tylko programista, też nie.
To niska poprzeczka i warto ją porządnie przeskoczyć. To także dobry moment, żeby sprawdzić, co twój dostawca powie twoim użytkownikom o modelu stojącym za odpowiedzią. Na naszej stronie o przejrzystości AI publikujemy model, licencję i prompt systemowy dla każdego tieru, więc możesz te informacje przekazać dalej, zamiast zgadywać.
Jak w dziesięć minut sprawdzić deklaracje dowolnego dostawcy o lokalizacji danych
Zrób to także z nami. Deklaracji, której nie da się sprawdzić, nie warto powtarzać własnym klientom.
- Znajdź listę podprocesorów. Jeśli jej nie ma, możesz skończyć w tym miejscu. Każdy poważny podmiot przetwarzający ją publikuje.
- Poszukaj kolumny z regionem i kolumny z podmiotem prawnym. Lista z regionami, ale bez podmiotów, ukrywa dokładnie to, co ważne.
- Policz spółki matki spoza UE. Nie po to, żeby kogoś dyskwalifikować, tylko żeby znać tę liczbę.
- Przeczytaj klauzulę o trenowaniu w regulaminie. Wyszukaj „train” (albo „trenowanie”) i przeczytaj każde trafienie.
- Poproś o dowód dla każdego zapytania. Przy każdej odpowiedzi API zwracamy tier, razem z liczbą tokenów i kosztem zapytania, a dokumentacja wymienia wszystkie nagłówki.
- Sprawdź retencję. Jak długo prompty są przechowywane, przez kogo i czy możesz to wyłączyć?
Dziesięć minut takiego sprawdzania jest warte więcej niż godzina lektury strony dostawcy o suwerenności, bo te odpowiedzi wynikają ze struktury. Nie zmieniają się razem z tekstami marketingowymi.
Co deklarujemy, a czego odmawiamy deklarować
Deklarujemy, że cała inferencja AI działa w Unii Europejskiej, że twoje prompty i odpowiedzi nigdy nie trafiają do Stanów Zjednoczonych ani do Chin oraz że modele działają pod naszym zarządem i nigdy nie są trenowane na danych klientów.
Nie deklarujemy, że żadne dane nie opuszczają UE, bo na drodze są hosting, baza danych i płatności. Nie deklarujemy w pełni suwerennego stosu i nie twierdzimy, że CLOUD Act nas nie dotyczy. Technicznie da się umieścić każdą warstwę w Europie. Nie da się dziś jednocześnie tego zrobić, utrzymać niezawodnego działania i trzymać cen z naszego cennika. Jeśli to się zmieni, przeniesiemy się i poinformujemy o tym.
Jeśli następna rzecz, którą ważysz, to pieniądze, tekst o tym, ile naprawdę kosztuje API AI za token, przeprowadza ten sam test uczciwości, tyle że na cenach, a nie na geografii.
Najczęściej zadawane pytania
Czym różni się lokalizacja danych od suwerenności danych?
Lokalizacja danych (data residency) to kwestia geografii: w jakim kraju stoi maszyna, która przetwarza twoje dane. Suwerenność danych to kwestia jurysdykcji: który rząd może zmusić firmę kontrolującą tę maszynę do działania. Zbiór danych może leżeć w europejskim centrum danych, a mimo to być w zasięgu zagranicznych organów, jeśli operator ma spółkę matkę za granicą.
Czy amerykański CLOUD Act obejmuje dane przechowywane w Europie?
Co do zasady tak. CLOUD Act pozwala organom Stanów Zjednoczonych żądać od dostawców podlegających jurysdykcji USA wydania danych, które posiadają, przechowują lub kontrolują, bez względu na to, gdzie te dane leżą. Samo przechowywanie danych we Frankfurcie czy Amsterdamie nie wyprowadza ich poza ten zasięg, jeśli operator jest firmą amerykańską albo spółką zależną takiej firmy.
Czy amerykański dostawca AI może być zgodny z RODO?
Może. Zgodność z RODO to sprawa umów, zabezpieczeń przy transferach, ograniczenia celu i bezpieczeństwa, a nie samej geografii. Geografia zmienia coś innego: twoją ekspozycję na żądania dostępu z zagranicy i to, jak łatwo wytłumaczyć twoją konfigurację organowi nadzorczemu albo klientowi.
Jak udowodnić audytorowi, gdzie są przetwarzane moje zapytania do AI?
Poproś dostawcę o pisemną listę podprocesorów z regionem przetwarzania dla każdego podmiotu, o umowę powierzenia przetwarzania danych (DPA) i o nagłówek odpowiedzi albo wpis w logu, który podaje region dla pojedynczego zapytania. Deklaracja na stronie marketingowej nie jest dowodem. Podpisana DPA plus dowód dla każdego zapytania już tak.
Czy RODO wymaga, żeby dane zostały w UE?
Nie. RODO nie wymaga, żeby dane osobowe zostawały w UE: reguluje ich przekazywanie poza Unię i dopuszcza je przy odpowiednich zabezpieczeniach, takich jak decyzja stwierdzająca odpowiedni stopień ochrony albo standardowe klauzule umowne. Przetwarzanie w UE to sposób, żeby ta dokumentacja była krótka i łatwa do wytłumaczenia, a nie obowiązek prawny sam w sobie.
Czym różni się hosting w UE od firmy z UE?
Hosting w UE to kwestia geografii: sprzęt stoi w państwie członkowskim. Firma z UE to kwestia jurysdykcji: sądy i organy którego państwa mogą zmusić operatora do działania. Europejski region prowadzony przez firmę ze spółką matką w Stanach Zjednoczonych daje ci to pierwsze bez drugiego, a tylko to drugie odpowiada na pytanie o dostęp z zagranicy.