Suwerenna AI w Europie: co to znaczy w praktyce
Suwerenna AI to cztery osobne pytania: budynek, operator, wagi i wartości. Na które Europa odpowiada już dziś i co możesz zrobić jeszcze w tym kwartale.
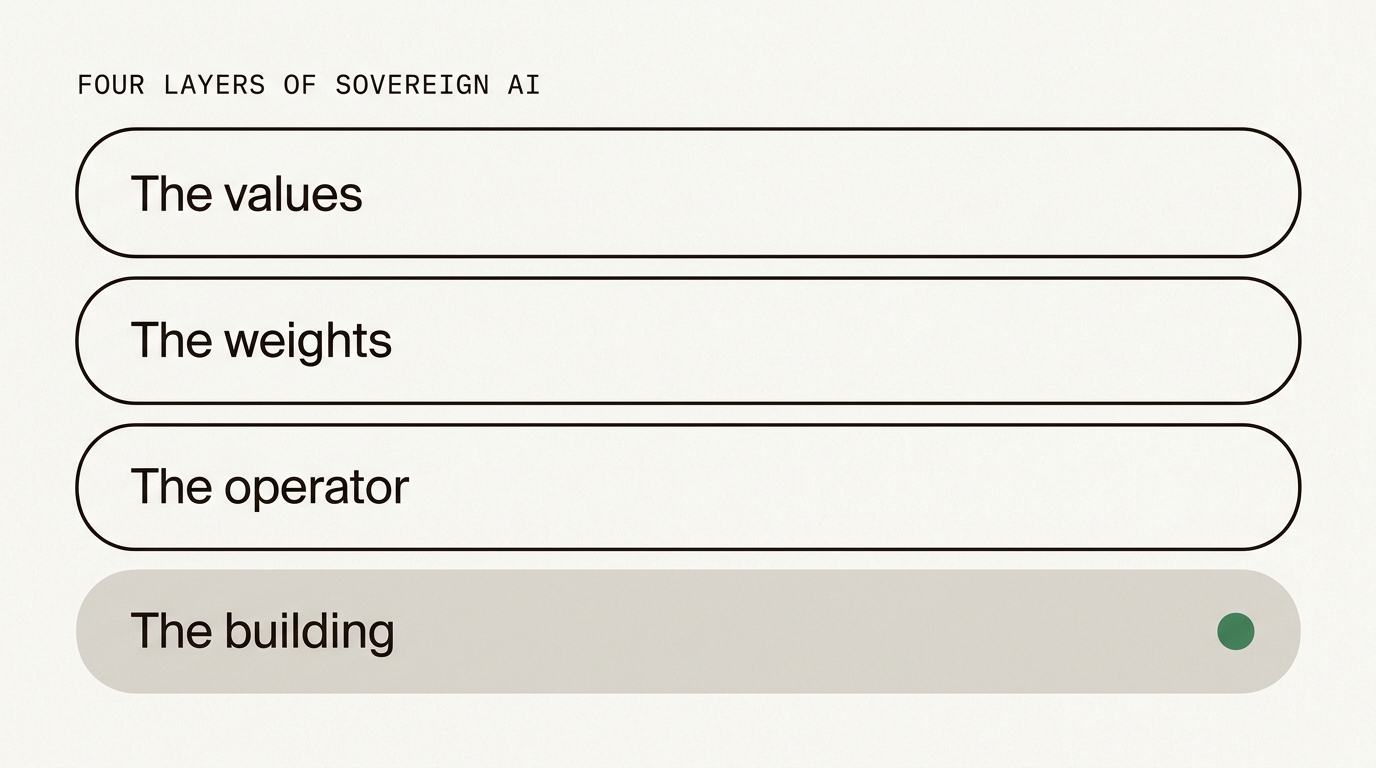
Suwerenna AI to nie jedna cecha. To cztery pytania ułożone jedno na drugim: gdzie stoi sprzęt, które państwo może wydać polecenie firmie, która go obsługuje, kto wytrenował model i czyje założenia model w sobie niesie. Na pierwsze Europa odpowiada dobrze, na drugie z zastrzeżeniami, a na trzecie i czwarte tylko częściowo. Kto sprzedaje ci wszystkie cztery w jednym słowie, sprzedaje ambicję.
Warto to powiedzieć wprost, zanim w rozmowie pojawi się jakikolwiek produkt, także nasz. Sensowna wersja tej debaty to nie „europejskie czy amerykańskie”. Brzmi ona: której warstwy stosu naprawdę potrzebuje to konkretne zadanie i ile kosztuje przeniesienie tej warstwy?
Co właściwie znaczy suwerenna AI
Słowo przyszło z debaty o mocy obliczeniowej, gdzie miało precyzyjne znaczenie: państwo powinno móc uruchamiać krytyczne systemy bez zgody innego państwa. Przeniesione na AI rozciągnęło się na wszystko, od kodu pocztowego centrum danych po poglądy polityczne chatbota, i po drodze straciło większość swojej przydatności.
Rozłóż je z powrotem na części, a każdą da się sprawdzić.
Suwerenność to nie odznaka na stronie docelowej. To cztery pytania z czterema różnymi odpowiedziami, a uczciwi dostawcy mówią ci, na które z nich odpowiadają.
Budynek to geografia: w jakim kraju stoi sprzęt. Operator to jurysdykcja: jaki system prawny wiąże firmę, która ten sprzęt obsługuje. Wagi to pochodzenie: kto wytrenował model, na jakich danych i na jakiej licencji. Wartości to zachowanie: co model mówi, czego odmawia i w czym po cichu myli się co do twojej części świata.
Kto w Europie może dziś zapewnić każdą warstwę
| Warstwa | Pytanie | Europa dziś |
|---|---|---|
| Budynek | Gdzie stoi sprzęt? | Załatwione. Europejska moc obliczeniowa jest realna i można ją zarezerwować |
| Operator | Które państwo może wydać polecenie operatorowi? | Dostępny dla inferencji, trudniej o hosting, bazy danych i płatności |
| Wagi | Kto wytrenował model? | Skromnie, ale coraz lepiej, a lukę w mocy obliczeniowej właśnie się zasypuje |
| Wartości | Co model powie i czego odmówi? | Częściowo, i to głównie przez dokumentację, a nie trenowanie |
Im wyżej, tym trudniej, i tym wyższa cena każdej warstwy. Wynajęcie europejskiej mocy obliczeniowej to decyzja zakupowa. Wytrenowanie w Europie konkurencyjnego modelu z czołówki to wieloletni projekt przemysłowy i właśnie na to idzie obecna fala unijnego finansowania.
Gdzie fizycznie stoi sprzęt?
- Co Europa może dziś zapewnić
- Załatwione. Europejska moc w centrach danych jest realna, można ją zarezerwować i wciąż rośnie.
- Co robi Union AI
- Cała inferencja AI działa na infrastrukturze w Unii Europejskiej.
Jedna zielona kropka na cztery. Dostawca, który dziś obiecuje wszystkie cztery, opisuje ambicję, a nie stos, który możesz kupić.
Czy są europejskie LLM, których warto używać?
Tak, choć uczciwy obraz to młoda dziedzina, a nie gotowa. Dzieli się na dwa rodzaje wysiłków.
Pierwszy jest komercyjny. Europejskie laboratoria wypuszczają modele open-weight, które możesz pobrać i uruchomić samodzielnie, a ich mniejsze modele są naprawdę konkurencyjne w codziennej pracy. To ta część europejskiego stosu, która już dziś działa na produkcji.
Drugi jest publiczny. OpenEuroLLM to konsorcjum europejskich uczelni, centrów HPC i firm, finansowane z programu Cyfrowa Europa, które buduje otwarte modele bazowe obejmujące języki urzędowe UE i publikuje ich dane, kod i ewaluacje razem z wagami. Ta ostatnia część znaczy więcej niż wyniki modeli: model z publicznymi danymi treningowymi i ewaluacjami to model, który możesz audytować, a w czołówce prawie nic nie da się dziś audytować.
Pod oboma leży moc obliczeniowa. Program gigafabryk AI Komisji uruchamia 20 mld € za pośrednictwem instrumentu InvestAI na dużą moc treningową w Europie. Nieformalne zaproszenie do wyrażenia zainteresowania przyniosło 77 propozycji z 16 państw członkowskich i 60 lokalizacji, a budowa pierwszej lokalizacji ma ruszyć od 2027 roku. Czy to zamknie lukę w możliwościach, pozostaje otwartym pytaniem. Oznacza to jednak, że odpowiedź w 2029 roku nie będzie taka jak dziś, a to powód, by utrzymywać stos przenośnym, a nie by czekać.
Czy model można wytrenować na europejskich wartościach?
Częściowo, a to sformułowanie zasługuje na więcej krytycznej uwagi, niż zwykle dostaje. „Trenowany na europejskich wartościach” wykonuje trzy osobne zadania i tylko dwa z nich da się sprawdzić.
Język to wartość i da się go zmierzyć
Model, który radzi sobie z niderlandzkim, fińskim, greckim i portugalskim tak dobrze jak z angielskim, to dla europejskich użytkowników inny produkt niż model, który traktuje te języki po macoszemu. Obsługę języków sprawdzisz w jedno popołudnie: puść własne prompty we własnych językach i porównaj. To najbardziej przydatny test w całej debacie o suwerenności i prawie nikt nie robi go przed zakupem.
Odmowy zdradzają trenowanie
Niektóre modele open-weight są trenowane w systemach prawnych z własnymi wrażliwościami i uchylają się od pytań o fakty z polityki czy historii, które europejski użytkownik uznałby za zupełnie zwyczajne. Traktujemy to jako wadę, a nie funkcję bezpieczeństwa. Gdy nasz system wykryje taką odmowę w pierwszym zdaniu odpowiedzi, anuluje odpowiedź i puszcza pytanie jeszcze raz na modelu bez tego martwego punktu, najwyżej raz na zapytanie, i informuje cię o tym w nagłówku X-EU-Routed. Nie obchodzimy natomiast prawdziwych odmów ze względów bezpieczeństwa: te zostają odmowami, bo przekierowywanie, aż model się zgodzi, to zautomatyzowany jailbreak.
Cała reszta to dokumentacja, a nie trenowanie
Resztę tego, co ludzie rozumieją przez wartości, czyli że model jest sprawiedliwy, wyważony i odpowiedni, nie da się zweryfikować na podstawie strony marketingowej. Zweryfikować możesz za to, czy dostawca publikuje model, licencję, prompt systemowy i zmierzony odsetek odmów. My publikujemy wszystkie cztery na naszej stronie o przejrzystości AI, łącznie z tym, co stawia nas w gorszym świetle.
Czy bezpieczeństwo danych wymaga europejskiego modelu?
Nie, a mieszanie tych dwóch spraw kosztuje zespoły prawdziwe pieniądze. To, gdzie wytrenowano model, i to, gdzie przetwarzany jest twój prompt, to niezależne od siebie fakty.
Wagi to plik. Pobierz model open-weight, uruchom go na europejskim sprzęcie, a twój prompt trafi na ten sprzęt i z niego wróci, niezależnie od tego, kto model wytrenował. Z wagami podróżuje zachowanie, a nie przepływ danych. Dlatego nasz stos może uczciwie przyznawać, że działa głównie na modelach spoza Europy, a jednocześnie przetwarzać każde zapytanie w Unii Europejskiej. I dlatego dla ochrony danych ścieżka zapytania znaczy więcej niż historia pochodzenia modelu.
Cztery pytania o bezpieczeństwo danych, które warto zadać każdemu dostawcy, europejskiemu czy nie: gdzie przetwarzana jest inferencja, jak długo przechowywane są prompty, czy służą do trenowania i które podmioty w łańcuchu mają spółkę matkę spoza UE. Nasze odpowiedzi są na stronie podprocesorów, także te niewygodne.
Co możesz zrobić jeszcze w tym kwartale
Suwerenność jako decyzja zakupowa się nie sprawdza, bo nic na rynku nie spełnia wszystkich czterech warstw. Suwerenność jako seria małych kroków działa. Mniej więcej w kolejności opłacalności:
- Sklasyfikuj zadania, zanim wybierzesz dostawców. Większość zespołów ma jeden wycinek naprawdę wrażliwego ruchu i dużą większość zwyczajnego. Znajomość tych proporcji zmienia to, za które kompromisy warto płacić.
- Najpierw przenieś wrażliwy wycinek. Umowy z klientami, akta kadrowe, notatki o pacjentach, niewydany kod. Streszczanie publicznych stron internetowych zostaw tam, gdzie jest.
- Poproś na piśmie o listę podprocesorów i klauzulę o trenowaniu. Nie o rozmowę handlową. O listę z regionami i podmiotami prawnymi, plus przeszukanie warunków pod kątem słowa „train”.
- Niech interfejs będzie nudny. API zgodne z OpenAI jest warte więcej niż jakakolwiek deklaracja suwerenności, bo przeprowadzka staje się tania. Przenośność to jedyna forma przewagi negocjacyjnej, która przetrwa zmianę zdania dostawcy. Nasze API jest opisane w dokumentacji API, a na czym naprawdę polega zmiana, wyjaśnia tekst zmiana dostawcy w trzech linijkach.
- Loguj dowody dla każdego zapytania. Nagłówek, który podaje tier, liczbę tokenów i koszt, zamienia deklarację w ścieżkę audytu.
- Powtórz test za pół roku. Europejski krajobraz modeli zmienia się szybciej niż jakikolwiek cykl zakupowy. Założenia z zeszłego roku są już nieaktualne.
Nic z tego nie wymaga przebudowy i wszystko to przetrwa, w którą stronę by nie poszedł rynek.
Gdzie pasujemy, a gdzie nie
Union AI to europejska usługa działająca na modelach open-weight, z całą inferencją AI na infrastrukturze w Unii Europejskiej, z przedpłatą w euro i ceną za token. W pełni pokrywamy dolną warstwę, w większości warstwę operatora, a o dwóch wyższych mówimy otwarcie.
Nasze modele są open-weight na licencjach Apache 2.0 i MIT i większości z nich nie wytrenowano w Europie. Jedyny model wytrenowany w Europie w naszym stosie to dziś model Mistral, na który przełączamy się na najtańszym tierze, gdy zawiedzie model podstawowy. Wolimy napisać to zdanie, niż pozwolić, by słowo „suwerenny” wykonało pracę za nas.
Jak wypadamy na tle trzech pozostałych sposobów kupowania AI w Europie, łącznie z wierszami, w których przegrywamy, znajdziesz w porównaniu europejskich dostawców AI.
Oferta jest więc celowo wąska. Jeśli chcesz, by twoje prompty były przetwarzane w Europie, przez europejskiego dostawcę, na modelach o udokumentowanym zachowaniu i z przewidywalnym rachunkiem, to istnieje już dziś i możesz zacząć jeszcze w tym tygodniu. Jeśli chcesz europejskiego modelu z czołówki, wytrenowanego na europejskich danych, to jest on w budowie, za publiczne pieniądze i według opublikowanego harmonogramu, i ani my, ani nikt inny nie może ci go jeszcze sprzedać.
Najczęściej zadawane pytania
Czym jest suwerenna AI?
Suwerenna AI to idea, że państwo albo unia może uruchamiać systemy AI, które kontroluje, na własnych warunkach. W praktyce rozpada się to na cztery pytania: gdzie stoi sprzęt, które państwo może wydać polecenie operatorowi, kto wytrenował model i czyje wartości model odzwierciedla. Większość dostawców odpowiada na jedno z czterech i używa tego słowa dla wszystkich.
Czy potrzebuję europejskiego LLM, żeby spełnić wymogi AI Act?
Nie. AI Act (unijny akt w sprawie sztucznej inteligencji) reguluje, jak systemy AI są budowane, dokumentowane i przedstawiane ludziom, a nie to, gdzie wytrenowano model. Amerykański albo chiński model open-weight można stosować zgodnie z prawem, a europejski niezgodnie. Zgodność dotyczy twoich obowiązków jako dostawcy lub podmiotu stosującego, a nie paszportu wag.
Czy modele open-weight to to samo co open source?
Nie, i ta różnica ma znaczenie. Open weight oznacza, że możesz pobrać model i uruchomić go samodzielnie, zwykle na licencji takiej jak Apache 2.0 albo MIT. Open source w pełniejszym sensie oznaczałby też opublikowane dane treningowe i odtwarzalny kod treningowy, czego większość modeli open-weight nie zapewnia.
Czy mogę używać chińskiego modelu open-weight i nadal trzymać dane w Europie?
Tak. Wagi to plik. Gdy pobierzesz model i uruchomisz go na europejskiej infrastrukturze, twoje prompty trafiają na ten sprzęt i nigdzie indziej, niezależnie od tego, kto wytrenował model. Z wagami nie podróżują twoje dane, tylko zachowanie modelu, w tym tematy, których nauczono go unikać.
Czy uruchomienie modelu w Europie sprawia, że moje dane są bezpieczne?
Usuwa jedną klasę ryzyka, a inne zostawia. Oznacza, że twoje prompty są przetwarzane na europejskiej infrastrukturze, a nie wysyłane za granicę, ale nic nie mówi o retencji, trenowaniu na twoich danych wejściowych, kontroli dostępu ani o tym, czy operator ma spółkę matkę spoza UE. Zapytaj o każdą z tych czterech rzeczy osobno.
Co to znaczy, że model jest trenowany na europejskich wartościach?
W praktyce chodzi o trzy sprawdzalne rzeczy: że dobrze radzi sobie z językami europejskimi, że odpowiada na pytania o fakty z polityki i historii zamiast ich unikać, oraz że jego dane treningowe i zachowanie przy odmowach są udokumentowane. To nie jest hasło, które da się zweryfikować, więc traktuj je jako zestaw testów do przeprowadzenia, a nie etykietę, której się ufa.
Które projekty UE trenują europejskie modele językowe?
Najbardziej widoczny jest OpenEuroLLM: konsorcjum europejskich uczelni, centrów HPC i firm, finansowane z programu Cyfrowa Europa, które buduje otwarte modele obejmujące języki urzędowe UE i publikuje dane oraz ewaluacje razem z wagami. Pod spodem program gigafabryk AI Komisji uruchamia 20 mld euro za pośrednictwem instrumentu InvestAI na moc treningową, której te modele potrzebują.