AI och datalokalisering i EU: vart går prompterna?
Vad datalokalisering för AI i EU faktiskt betyder, varför det inte är suveränitet och hur du kontrollerar var en AI-leverantör behandlar dina prompter.
Din prompt skickas till en maskin i en byggnad med en adress. Datalokalisering för AI i EU betyder att byggnaden ligger inom Europeiska unionen, och det är ett faktum du kan kontrollera. Det är inte samma sak som suveränitet, som handlar om vilken stat som kan tvinga bolaget som äger maskinen, och de flesta leverantörer låter gärna de två flyta ihop.
Union AI kör all AI-inferens på infrastruktur inom Europeiska unionen. Vår hosting, vår databas och vår betalhantering involverar bolag med amerikanska moderbolag, så vi påstår inte att ingen data någonsin lämnar EU. Den meningen är hela poängen med det här inlägget: lokalisering är en verklig och användbar egenskap, och den räcker inte i närheten så långt som ordet suverän antyder.
Lämnar mina data EU när jag använder ett AI-API?
Frågan har inget enkelt svar, eftersom ”mina data” är minst fyra olika saker som färdas på olika sätt. Att dela upp dem är det snabbaste sättet att ta sig förbi marknadsföringstexten.
| Data | Vad det är | Vart det går hos Union AI |
|---|---|---|
| Prompt och svar | Texten du skickar och svaret modellen skriver | Behandlas inom Europeiska unionen, aldrig i USA eller Kina |
| Konto- och användningsdata | Ditt konto, ditt saldo, antal tokens, tidsstämplar | En EU-region, driven av ett bolag med amerikanskt moderbolag |
| Faktureringsdata | Namn, e-post, momsregistreringsnummer, betaluppgifter | Behandling i EU, amerikanskt moderbolag |
| Trafik under överföring | Den krypterade förfrågan på väg till oss | Genom Cloudflares edge, i dess EU-region |
De flesta leverantörer svarar med den första raden och slutar där. Det är den rad som betyder mest, eftersom det är där ditt kundavtal, din journalanteckning eller din opublicerade kod faktiskt läses. Det är också den rad som är lättast att vara ärlig om, vilket gör tystnaden kring de andra tre talande.
Datalokalisering, suveränitet och jurisdiktion är tre olika saker
Datalokalisering (data residency) är geografi. Den svarar på frågan: i vilket land står hårdvaran som lagrar eller behandlar datan? Det går att kontrollera, och en leverantör som inte vill svara säger något med det.
Jurisdiktion är rättslig räckvidd. Den svarar på: vilken stats domstolar och myndigheter kan utfärda ett bindande föreläggande mot bolaget som kontrollerar hårdvaran? Jurisdiktionen följer bolaget, inte kabeln.
Datasuveränitet är påståendet att svaren på båda frågorna hamnar på samma ställe och att ingen utländsk myndighet kan komma åt dina data. Det är det starkaste påståendet av de tre, och det görs oftast av bolag som inte kan belägga det.
Region är inte samma sak som jurisdiktion. Ett amerikanskt moderbolag omfattas av CLOUD Act, och det ändrar ingenting om var dina prompter behandlas, men det ändrar vad någon ärligt kan lova om dem.
Suveränitet i full mening har fler lager än de här två, och systerartikeln om europeisk suverän AI tar isär alla fyra. Den skillnaden är skälet till att vår sida om underbiträden listar tre parter med amerikanska moderbolag i stället för att gömma dem bakom en europeisk flagga. En lista som utelämnar de obekväma raderna är inte transparens, det är reklam.
Når den amerikanska CLOUD Act data som lagras i Europa?
Ja, i princip. Clarifying Lawful Overseas Use of Data Act från 2018 låter amerikanska myndigheter kräva att en leverantör under amerikansk jurisdiktion lämnar ut data som den har i sin besittning, förvaring eller kontroll, var i världen datan än lagras. Ett datacenter i Frankfurt placerar inte data utom räckhåll om operatören är ett amerikanskt bolag eller dotterbolag till ett.
Vad det betyder i praktiken
Det betyder inte att någon läser dina prompter. Det betyder att den rättsliga frågan ”vem skulle kunna tvingas lämna ut det här?” har ett annat svar än den tekniska frågan ”var körs det här?”, och du bör besvara båda innan du skriver under något.
För de flesta team är den praktiska konsekvensen begränsad. Behandlar du vanliga affärsdata är exponeringen en risk att dokumentera snarare än ett skäl till panik. Hanterar du patientjournaler, juridiska akter, affärshemligheter eller något som omfattas av tystnadsplikt är svaret på jurisdiktionsfrågan en del av din efterlevnad, och dina kunder kommer förr eller senare att be om det skriftligt.
Vad som faktiskt minskar exponeringen
Fyra saker, ungefär i ordning efter effekt:
- Färre parter med utländska moderbolag i kedjan. Varje part du tar bort är ett mål för ett föreläggande mindre.
- Att hålla innehåll och identitet isär. Vår inferensleverantör ser prompten men inte vem som skickade den. Vår databas ser vem du är men inte vad du frågade.
- Kort lagringstid. Data som inte längre finns kan inte lämnas ut.
- Kryptering där du själv har nycklarna, där arbetslasten tillåter det. Inferens är den arbetslast där det oftast inte går, eftersom modellen måste läsa texten.
Din dator
Där du befinner dig
- Kan läsa
- Prompten i klartext, innan något krypterar den.
- Kan inte läsa
- Ingenting. Det här är det enda steget du har full kontroll över.
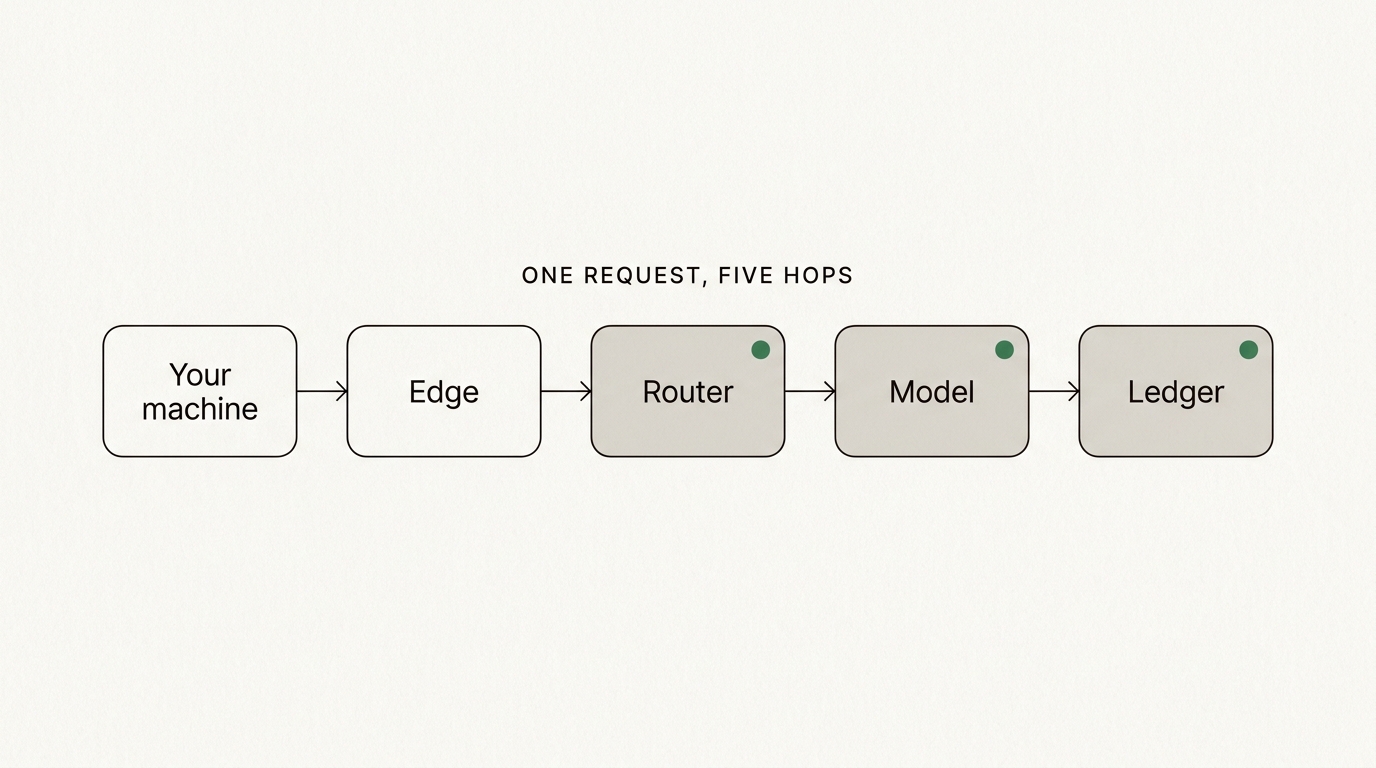
Varje steg efter din egen dator körs inom Europeiska unionen, och bara modellen läser din prompt.
Vilka delar av en förfrågan kan läsa din prompt?
Fem steg, och bara ett av dem läser texten. Att gå igenom dem är skillnaden mellan ett påstående och en förståelse.
Din egen dator har prompten i klartext innan något krypterar den. Edge-lagret avslutar TLS, så din förfrågan passerar den maskinens minne, och ingenting cachas där. Vår router ser din nyckel, ditt saldo och den nivå du bad om, och skickar vidare prompten utan att skriva ner den. Modellen läser prompten och skriver svaret, på infrastruktur inom Europeiska unionen, utan att veta vem du är. Reskontran registrerar antal tokens, en tidsstämpel och ett pris, och aldrig innehållet.
Edge-lagret körs i Cloudflares EU-region, så det steg som avslutar TLS ligger också inom Europeiska unionen. Hela listan över parter, med region och den juridiska person som står bakom var och en, finns på sidan om underbiträden.
Vad förväntar sig GDPR att du vet om din AI-leverantör?
Mer än de flesta köpare frågar efter. Enligt dataskyddsförordningen (GDPR) är du oftast personuppgiftsansvarig och din AI-leverantör personuppgiftsbiträde, vilket betyder att du är skyldig dina egna användare ett svar om vem som behandlar deras uppgifter, var och på vilken rättslig grund. Tre konkreta saker följer av det.
Du behöver ett personuppgiftsbiträdesavtal (DPA) som anger rollerna och skyddsåtgärderna. Vårt publiceras i sin helhet på DPA-sidan, det skickas inte på begäran efter ett säljsamtal. Du behöver en aktuell lista över underbiträden, med rätt att invända innan en ny part läggs till. Och du behöver veta om prompter används för träning, eftersom det ändrar ändamålet med behandlingen, inte bara risken.
Vilka av dina data som över huvud taget får läggas in i ett AI-verktyg är en annan fråga än var verktyget körs, och den gås igenom, med en användarpolicy du kan kopiera, i följer ChatGPT GDPR för företagsdata.
Tillsynsmyndigheterna håller fortfarande på att reda ut hur GDPR gäller för själva modellerna. Europeiska dataskyddsstyrelsens yttrande 28/2024 om dataskyddsaspekter av AI-modeller, antaget i december 2024, beskriver när en modell som tränats på personuppgifter kan betraktas som anonym och när berättigat intresse kan fungera som rättslig grund. Det återkommande svaret är att det måste bedömas från fall till fall, vilket är otillfredsställande och också korrekt. Den som säljer en efterlevnadsgaranti på en rad säljer en saga.
Vad som ändrades den 2 augusti 2026 enligt AI-förordningen
Transparenskraven i artikel 50 i AI-förordningen (AI Act), förordning (EU) 2024/1689, började gälla den 2 augusti 2026. Bygger du ett system som pratar med människor har du nu en rättslig skyldighet att se till att de vet att de pratar med en maskin.
Europeiska kommissionens vägledning om transparenskraven enligt artikel 50 är tydlig med hur: användarna ska informeras från början av den första interaktionen, på ett tydligt och urskiljbart sätt. En rad begravd i dina användarvillkor räknas inte. Inte heller en etikett som bara en utvecklare skulle känna igen.
Ribban är låg och värd att ta sig över ordentligt. Det är också ett bra tillfälle att kontrollera vad din leverantör kan berätta för dina användare om modellen bakom svaret. Vi publicerar modellen, licensen och systemprompten för varje nivå på vår sida om AI-transparens, så att du kan föra det vidare i stället för att gissa.
Så kontrollerar du en leverantörs påståenden om datalokalisering på tio minuter
Gör det med oss också. Ett påstående du inte kan verifiera är ett påstående du inte bör upprepa för dina egna kunder.
- Hitta listan över underbiträden. Finns det ingen kan du sluta här. Varje seriöst personuppgiftsbiträde publicerar en.
- Leta efter en kolumn för region och en för juridisk person. En lista med regioner men utan juridiska personer döljer precis det som spelar roll.
- Räkna moderbolagen utanför EU. Inte för att diskvalificera dem, utan för att känna till siffran.
- Läs träningsklausulen i villkoren. Sök efter ”train” och läs varje träff.
- Be om bevis per förfrågan. Vi returnerar nivån i varje API-svar, tillsammans med antalet tokens och vad förfrågan kostade, och dokumentationen listar varje header.
- Kontrollera lagringstiden. Hur länge sparas prompterna, av vem, och kan du stänga av det?
Tio minuter av det här slår en timme med en leverantörs sida om suveränitet, eftersom svaren är strukturella. De ändras inte med marknadsföringstexten.
Vad vi påstår, och vad vi vägrar påstå
Vi påstår att all AI-inferens körs inom Europeiska unionen, att dina prompter och svar aldrig skickas till USA eller Kina, och att modellerna körs under vår förvaltning och aldrig tränas på kunddata.
Vi påstår inte att ingen data lämnar EU, eftersom hosting, databas och betalningar finns i kedjan. Vi påstår inte att vi har en helt suverän stack, och vi påstår inte att vi är fria från CLOUD Act. Tekniskt går det att lägga varje lager i Europa. Det går inte i dag att göra det, driva det pålitligt och ta de priser som står på vår prissida. Om det ändras flyttar vi, och då berättar vi det.
Är det pengasidan du väger härnäst går systerartikeln om vad ett AI-API faktiskt kostar per token igenom samma ärlighetstest, fast på priser i stället för geografi.
Vanliga frågor
Vad är skillnaden mellan datalokalisering och datasuveränitet?
Datalokalisering handlar om geografi: i vilket land maskinen som behandlar dina data står. Datasuveränitet handlar om jurisdiktion: vilken stat som kan tvinga bolaget som kontrollerar maskinen. En datamängd kan ligga i ett europeiskt datacenter och ändå nås av en utländsk myndighet om operatören har ett moderbolag utomlands.
Gäller den amerikanska CLOUD Act för data som lagras i Europa?
I princip, ja. CLOUD Act låter amerikanska myndigheter kräva att leverantörer under amerikansk jurisdiktion lämnar ut data som de har i sin besittning, förvaring eller kontroll, oavsett var datan lagras. Att lagra data i Frankfurt eller Amsterdam placerar den inte i sig utom räckhåll om operatören är ett amerikanskt bolag eller dotterbolag till ett.
Kan en amerikansk AI-leverantör följa GDPR?
Det kan den. Att följa GDPR är en fråga om avtal, skyddsåtgärder vid överföring, ändamålsbegränsning och säkerhet, inte enbart om geografi. Det geografin ändrar är hur exponerad du är för utländska begäranden om åtkomst och hur lätt det är att förklara din lösning för en tillsynsmyndighet eller en kund.
Hur bevisar jag för en revisor var mina AI-förfrågningar behandlas?
Be leverantören om en skriftlig lista över underbiträden med behandlingsregion per part, ett personuppgiftsbiträdesavtal och en svarsheader eller loggpost som anger regionen för en enskild förfrågan. Ett påstående på en marknadsföringssida är inget bevis. Ett undertecknat personuppgiftsbiträdesavtal plus bevis per förfrågan är det.
Kräver GDPR datalokalisering i EU?
Nej. GDPR kräver inte att personuppgifter stannar inom EU; förordningen reglerar överföringar ut ur unionen och tillåter dem med rätt skyddsåtgärder, till exempel ett beslut om adekvat skyddsnivå eller standardavtalsklausuler. Att hålla behandlingen inom EU är ett sätt att göra pappersarbetet kort och lätt att förklara, inte en rättslig skyldighet i sig.
Vad är skillnaden mellan hosting i EU och ett EU-bolag?
Hosting i EU handlar om geografi: hårdvaran står i en medlemsstat. Ett EU-bolag handlar om jurisdiktion: vilken stats domstolar och myndigheter som kan tvinga operatören. En europeisk region som drivs av ett företag med amerikanskt moderbolag ger dig det första utan det andra, och bara det andra besvarar frågan om utländsk åtkomst.