Europeisk suverän AI: vad det betyder i praktiken
Suverän AI är fyra separata frågor: byggnaden, operatören, vikterna och värderingarna. Vad Europa kan svara på i dag, och vad du kan göra det här kvartalet.
Suverän AI är inte en enda egenskap. Det är fyra frågor staplade på varandra: var hårdvaran står, vilken stat som kan tvinga företaget som driver den, vem som tränade modellen och vems antaganden modellen bär med sig. Europa kan svara bra på den första, på den andra med förbehåll och på den tredje och fjärde bara delvis. Den som säljer dig alla fyra i ett ord säljer dig en ambition.
Det är värt att säga rakt ut innan någon produkt kommer in i samtalet, vår egen inräknad. Den användbara versionen av debatten är inte ”europeiskt eller amerikanskt”. Den är: vilket lager i stacken behöver just den här arbetslasten, och vad kostar det att flytta det lagret?
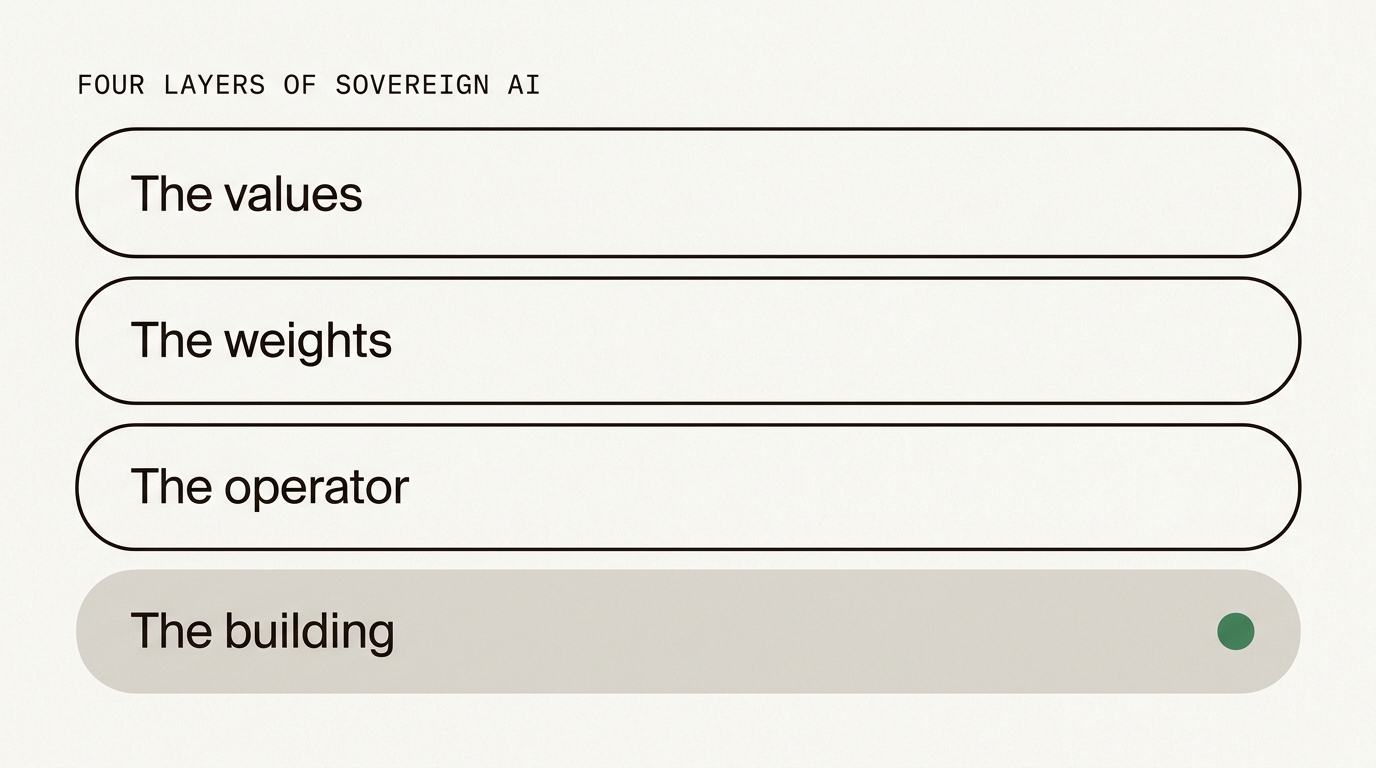
Vad suverän AI faktiskt betyder
Ordet kom från debatten om beräkningskapacitet, där det hade en precis betydelse: en stat ska kunna köra kritiska system utan en annan stats tillstånd. När det tillämpades på AI töjdes det ut till att täcka allt från datacentrets postnummer till en chattbots politiska lutning, och tappade det mesta av sin nytta på vägen.
Dela upp det i sina delar igen, så går varje del att kontrollera.
Suveränitet är inget märke på en landningssida. Det är fyra frågor med fyra olika svar, och de ärliga leverantörerna talar om vilka de svarar på.
Byggnaden är geografi: i vilket land hårdvaran står. Operatören är jurisdiktion: vilket rättssystem som binder företaget som driver hårdvaran. Vikterna är ursprung: vem som tränade modellen, på vilken data och under vilken licens. Värderingarna är beteende: vad modellen säger, vägrar och i det tysta får fel om din del av världen.
Vem kan leverera varje lager i Europa i dag?
| Lager | Frågan | Europa i dag |
|---|---|---|
| Byggnaden | Var står hårdvaran? | Löst. Europeisk kapacitet är verklig och går att boka |
| Operatören | Vilken stat kan tvinga operatören? | Finns för inferens, svårare för hosting, databaser och betalningar |
| Vikterna | Vem tränade modellen? | Tunt men på väg upp, med ett beräkningsgap som byggs ut nu |
| Värderingarna | Vad kommer modellen att säga och vägra? | Delvis, och mest genom dokumentation snarare än träning |
Lagren blir svårare ju högre upp du kommer, och priset för varje lager stiger i samma takt. Att hyra europeisk beräkningskapacitet är ett upphandlingsbeslut. Att träna en konkurrenskraftig frontiermodell i Europa är ett industriprojekt på flera år, och det är precis vad den nuvarande vågen av EU-finansiering är till för.
Var står hårdvaran fysiskt?
- Vad Europa kan leverera i dag
- Löst. Europeisk datacenterkapacitet är verklig, går att boka och växer.
- Vad Union AI gör
- All AI-inferens körs på infrastruktur inom Europeiska unionen.
En grön prick av fyra. En leverantör som påstår sig klara alla fyra i dag beskriver en ambition, inte en stack du kan köpa.
Finns det europeiska språkmodeller som är värda att använda?
Ja, och den ärliga bilden är ett ungt område snarare än ett färdigt. Det delar upp sig i två sorters insatser.
Den första är kommersiell. Europeiska labb släpper open-weight-modeller som du kan ladda ner och köra själv, och deras mindre modeller är verkligt konkurrenskraftiga för vardagligt arbete. Det här är den del av den europeiska stacken som redan fungerar i produktion i dag.
Den andra är offentlig. OpenEuroLLM är ett konsortium av europeiska universitet, HPC-center och företag, finansierat genom programmet för ett digitalt Europa, som bygger öppna grundmodeller som täcker EU:s officiella språk och publicerar data, kod och utvärderingar tillsammans med vikterna. Den sista delen väger tyngre än modellernas resultat: en modell vars träningsdata och utvärderingar är offentliga är en modell du kan granska, och nästan ingenting i frontlinjen går att granska i dag.
Under båda ligger beräkningskapaciteten. Kommissionens program för AI-gigafabriker mobiliserar 20 miljarder euro genom InvestAI-faciliteten för storskalig träningskapacitet i Europa, och den informella intresseanmälan gav 77 förslag från 16 medlemsstater och 60 platser, med byggstart för den första anläggningen väntad från 2027. Om det sluter kapacitetsgapet är en öppen fråga. Det betyder i alla fall att svaret 2029 inte blir samma som i dag, vilket är ett skäl att hålla din stack flyttbar snarare än att vänta.
Kan en modell tränas på europeiska värderingar?
Delvis, och uttrycket förtjänar mer granskning än det brukar få. ”Tränad på europeiska värderingar” gör tre olika jobb, och bara två av dem går att kontrollera.
Språk är en värdering, och det går att mäta
En modell som hanterar nederländska, finska, grekiska och portugisiska lika bra som engelska är en annan produkt för europeiska användare än en som behandlar dem som eftertankar. Språkstöd går att testa på en eftermiddag: kör dina egna prompter, på dina egna språk, och jämför. Det är det enskilt mest användbara testet i hela suveränitetsdebatten, och nästan ingen kör det innan de köper.
Vägranden avslöjar träningen
Vissa open-weight-modeller är tränade under rättssystem med egna känsligheter, och de duckar för faktafrågor om politik eller historia som en europeisk användare skulle se som helt vanliga. Vi behandlar det som en brist snarare än en säkerhetsfunktion. När vårt system upptäcker den sortens vägran i svarets första mening avbryter det svaret och kör frågan igen på en modell utan den blinda fläcken, högst en gång per förfrågan, och talar om att det hände i headern X-EU-Routed. Det vi inte gör är att runda verkliga säkerhetsvägranden: de förblir vägrade, eftersom att skicka vidare tills en modell går med på det vore en automatiserad jailbreak.
Allt annat är dokumentation, inte träning
Resten av det folk menar med värderingar, att en modell är rättvis, balanserad och lämplig, är inget du kan verifiera från en marknadsföringssida. Det du kan verifiera är om leverantören publicerar modellen, licensen, systemprompten och den uppmätta andelen vägranden. Vi publicerar alla fyra på vår sida om AI-transparens, inklusive de delar som får oss att se sämre ut.
Kräver datasäkerhet en europeisk modell?
Nej, och att blanda ihop de två kostar team riktiga pengar. Var en modell tränades och var din prompt behandlas är två oberoende fakta.
Vikter är en fil. Ladda ner en open-weight-modell, kör den på europeisk hårdvara, så går din prompt till den hårdvaran och tillbaka, oavsett vem som tränade modellen. Det som följer med vikterna är beteende, inte dataflöde. Därför kan vår stack vara ärlig med att den mest kör icke-europeiska modeller och ändå behandla varje förfrågan inom Europeiska unionen, och därför spelar förfrågans väg större roll för dataskyddet än modellens ursprungshistoria.
De fyra frågorna om datasäkerhet som är värda att ställa till varje leverantör, europeisk eller inte: var behandlas inferensen, hur länge sparas prompterna, används de för träning, och vilka parter i kedjan har ett moderbolag utanför EU. Våra svar finns på sidan om underbiträden, de obekväma inräknade.
Vad du faktiskt kan göra det här kvartalet
Suveränitet som ett inköpsbeslut misslyckas, eftersom ingenting på marknaden klarar alla fyra lager. Suveränitet som en rad små steg fungerar. Ungefär i ordning efter vad de ger:
- Klassificera arbetslasterna före leverantörerna. De flesta team har en liten del verkligt känslig trafik och en stor majoritet som är vanlig. Att känna till proportionen ändrar vilka avvägningar som är värda att betala för.
- Flytta den känsliga delen först. Kundavtal, personalakter, patientanteckningar, kod som inte släppts. Låt sammanfattningen av offentliga webbsidor ligga kvar där den är.
- Be om listan över underbiträden och träningsklausulen skriftligt. Inte ett säljsamtal. En lista med regioner och juridiska personer, plus en sökning efter ordet ”train” i villkoren.
- Håll gränssnittet tråkigt. Ett OpenAI-kompatibelt API är värt mer än något suveränitetslöfte, eftersom det gör det billigt att flytta. Portabilitet är den enda formen av förhandlingsstyrka som överlever att en leverantör ändrar sig. Vårt är dokumenterat i API-referensen, och vad ett byte faktiskt innebär står i byt på tre rader.
- Logga bevis per förfrågan. En header som anger nivån, antalet tokens och kostnaden gör ett påstående till ett granskningsspår.
- Kör testet igen om sex månader. Det europeiska modellandskapet rör sig snabbare än någon upphandlingscykel. Antaganden från förra året är inaktuella.
Inget av det kräver att du bygger om något, och allt håller oavsett vart marknaden tar vägen.
Där vi passar in, och där vi inte gör det
Union AI är en europeisk tjänst som kör open-weight-modeller, med all AI-inferens på infrastruktur inom Europeiska unionen, förbetald i euro och prissatt per token. Vi täcker det understa lagret helt, det mesta av operatörslagret, och vi är öppna med de två ovanför.
Våra modeller är open weight under Apache 2.0 och MIT, och de flesta av dem tränades inte i Europa. Den enda Europatränade modellen i vår stack i dag är Mistral-modellen som vi faller tillbaka på i den billigaste nivån när den primära modellen fallerar. Vi skriver hellre den meningen än låter ordet suverän göra jobbet åt oss.
Hur det står sig mot de tre andra sätten att köpa AI i Europa, inklusive raderna där vi förlorar, finns i europeiska AI-leverantörer jämförda.
Så erbjudandet är snävt med flit. Vill du att dina prompter behandlas i Europa, hos en europeisk leverantör, på modeller vars beteende är dokumenterat och vars faktura är förutsägbar, så finns det i dag och du kan börja den här veckan. Vill du ha en europeisk frontiermodell tränad på europeisk data, så håller den på att byggas, med offentliga pengar och en publicerad tidsplan, och varken vi eller någon annan kan sälja den till dig än.
Vanliga frågor
Vad är suverän AI?
Suverän AI är tanken att ett land eller en union kan köra AI-system som det själv kontrollerar, på egna villkor. I praktiken delar det upp sig i fyra frågor: var hårdvaran står, vilken stat som kan tvinga operatören, vem som tränade modellen och vems värderingar modellen speglar. De flesta leverantörer svarar på en av de fyra och använder ordet för alla.
Behöver jag en europeisk språkmodell för att följa AI-förordningen?
Nej. AI-förordningen (AI Act) reglerar hur AI-system byggs, dokumenteras och presenteras för människor, inte var modellen tränades. En amerikansk eller kinesisk open-weight-modell kan användas i enlighet med reglerna, och en europeisk modell kan användas i strid med dem. Regelefterlevnad handlar om dina skyldigheter som leverantör eller tillhandahållare, inte om vikternas pass.
Är open-weight-modeller samma sak som öppen källkod?
Nej, och skillnaden spelar roll. Open weight betyder att du kan ladda ner och köra modellen själv, oftast under en licens som Apache 2.0 eller MIT. Öppen källkod i fullare mening skulle också betyda publicerad träningsdata och reproducerbar träningskod, vilket de flesta open-weight-släpp inte erbjuder.
Kan jag använda en kinesisk open-weight-modell och ändå behålla datan i Europa?
Ja. Vikter är en fil. När du har laddat ner en modell och kör den på europeisk infrastruktur går dina prompter till den hårdvaran och ingen annanstans, oavsett vem som tränade modellen. Det som följer med vikterna är inte din data utan modellens beteende, inklusive ämnen som den har tränats att undvika.
Blir min data säker om modellen körs i Europa?
Det tar bort en typ av risk och lämnar andra kvar. Det betyder att dina prompter behandlas på europeisk infrastruktur i stället för att skickas utomlands, men det säger ingenting om lagringstid, träning på det du matar in, åtkomstkontroller eller om operatören har ett moderbolag utanför EU. Fråga om alla fyra var för sig.
Vad betyder det att en modell är tränad på europeiska värderingar?
I praktiken tre saker som går att kontrollera: att den hanterar europeiska språk väl, att den svarar på faktafrågor om politik och historia i stället för att undvika dem, och att dess träningsdata och vägranden är dokumenterade. Det är ingen slogan du kan verifiera, så se det som en uppsättning tester du kör snarare än en etikett du litar på.
Vilka EU-projekt tränar europeiska språkmodeller?
OpenEuroLLM är det mest synliga: ett konsortium av europeiska universitet, HPC-center och företag, finansierat genom programmet för ett digitalt Europa, som bygger öppna modeller som täcker EU:s officiella språk och publicerar data och utvärderingar tillsammans med vikterna. Under det mobiliserar kommissionens program för AI-gigafabriker 20 miljarder euro genom InvestAI-faciliteten för den träningskapacitet som modellerna behöver.