Följer ChatGPT GDPR för företagsdata?
Ja, på villkor. Vilken kontotyp, vilka klausuler och vilken data som avgör om ChatGPT följer GDPR, plus en AI-policy på en sida som ditt team faktiskt följer.
Ja, på villkor, och villkoren är hela historien. Dataskyddsförordningen (GDPR) certifierar inte verktyg, den reglerar behandling: samma chattbot kan användas lagligt av ett team och olagligt av teamet bredvid. Det som skiljer dem åt är vilken kontotyp de köpte, om det finns ett personuppgiftsbiträdesavtal, om det du matar in används för träning, och vilken data någon faktiskt klistrar in.
Den sista punkten är den som de flesta policyer missar. Ingen i ditt företag bestämmer ”ska vi använda AI”; de bestämmer, fyrtio gånger om dagen, om just det här stycket får hamna i rutan. En policy som besvarar den frågan på en sida slår en upphandlingsgranskning som inte besvarar någonting.
Det korta svaret, och de fyra villkoren
Vilken AI-assistent som helst kan ingå i en GDPR-kompatibel behandling om fyra saker gäller samtidigt.
- En rättslig grund för den underliggande behandlingen, som du behövde ändå. AI-verktyget skapar ingen och tar inte bort någon.
- Ett personuppgiftsbiträdesavtal med leverantören enligt artikel 28, eftersom personuppgifter i dina prompter gör leverantören till personuppgiftsbiträde.
- Ingen träning på det du matar in, skriftligt, i de villkor du faktiskt skrev under och inte i ett blogginlägg från leverantören.
- Ett svar om lagringstid: hur länge prompter sparas, av vem, och om du kan stänga av det.
Missar du ett av dem har du inte ett teoretiskt problem med regelefterlevnaden; du har ett stycke som du inte kan skriva i din egen integritetspolicy. Det är oftast i det ögonblicket som team upptäcker luckan.
Konsumentkonto eller företagskonto: skillnaden som spelar roll
Leverantörer säljer samma modell två gånger, på helt olika villkor. Det är inte modellen som skiljer sig.
| Konsumentabonnemang | Företags- eller API-plan | |
|---|---|---|
| Personuppgiftsbiträdesavtal | Oftast inget | Standard, ofta via självbetjäning |
| Träning på det du matar in | Ofta standard, ibland med opt-out | Normalt undantagen i avtalet |
| Kontroll över lagringstid | Ingen | Bestämd, ibland konfigurerbar |
| Vem som ansvarar | Den anställda som registrerade sig | Din organisation |
| Passar för | Offentligt material, privat bruk | Intern data och kunddata, under villkoren ovan |
Läs ditt eget avtal snarare än den här tabellen, eftersom villkoren ändras. Kontrollen tar tio minuter: öppna villkoren, sök efter ”train”, sök efter ”retention” och leta efter orden ”data processing agreement”. Ger en sökning på de tre ingenting är du på en konsumentprodukt, vad fakturan än säger.
Regelefterlevnad är ingen egenskap hos verktyget. Det är en egenskap hos upplägget mellan dig, leverantören och den data du skickar.
Behöver jag ett biträdesavtal för att använda AI på jobbet?
Om andra människors personuppgifter hamnar i dina prompter, ja. Du är personuppgiftsansvarig, AI-leverantören är personuppgiftsbiträde, och artikel 28 kräver att avtalet är skriftligt. Det gäller en sammanfattare, ett verktyg som skriver utkast till supportsvar och en kodassistent som råkar se ett kundnamn i en stack trace.
Vårt sammanfattas på DPA-sidan och texten att skriva under är ett mejl bort, inget säljsamtal, vilket är en rimlig måttstock att hålla varje leverantör till: om villkoren bara dyker upp när du väl är inne i en upphandling säger det något om hur ofta de ändras.
Två saker som folk förväntar sig att ett biträdesavtal gör men som det inte gör. Det ger dig ingen rättslig grund. Och det gör inte känsliga personuppgifter säkra att klistra in; hälsouppgifter, biometriska uppgifter och liknande behöver en egen bedömning, och den franska tillsynsmyndighetens vägledning om AI och GDPR är en rimlig utgångspunkt för vad den bedömningen bör täcka.
Offentligt
Vilket verktyg som helst, även ett gratiskonto.
Den är redan offentlig. Inget du klistrar in kan läcka något som världen inte redan kan läsa.
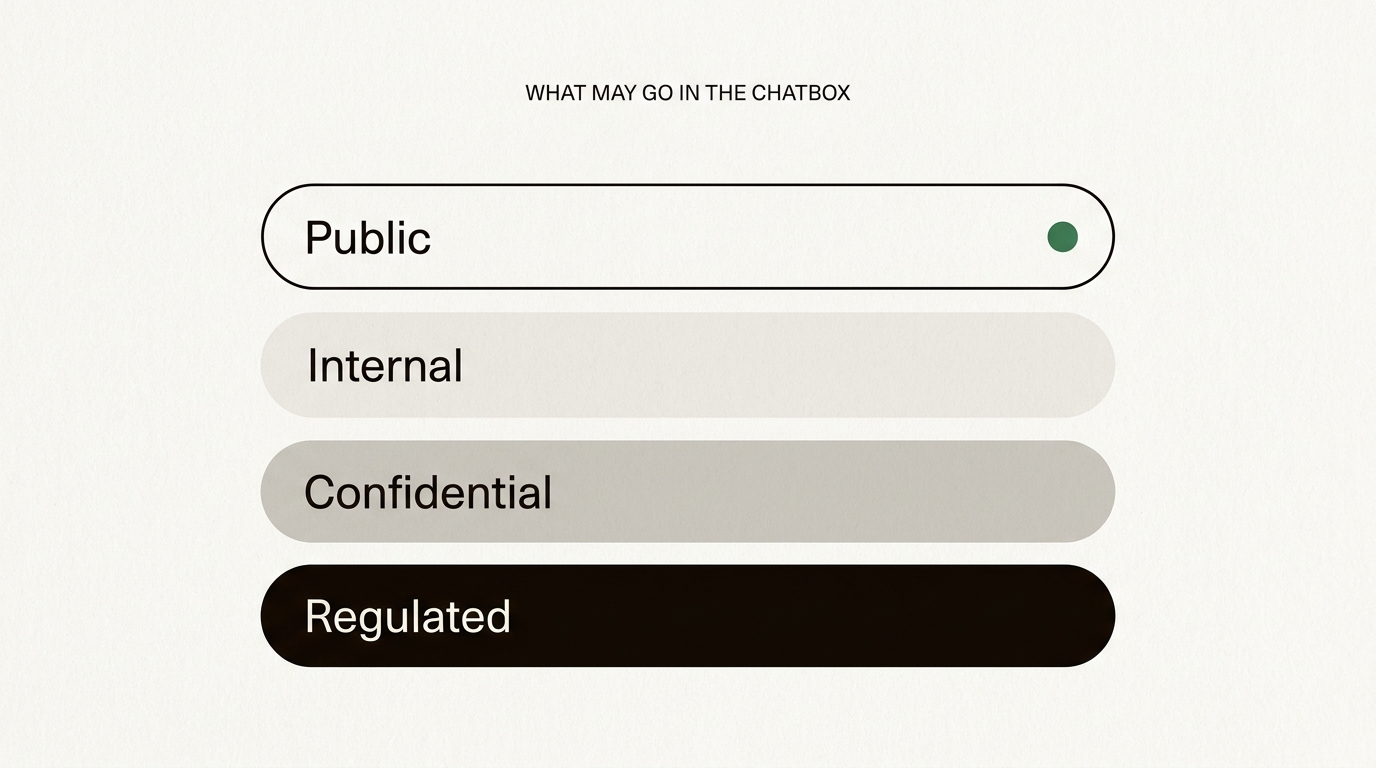
Fyra klasser, en regel var, och klassen följer med datan snarare än med verktyget. Din egen klassificering kanske drar gränserna på andra ställen, och det är okej så länge den är nedskriven och någon äger den.
De fyra dataklasserna, och vad som får gå vart
Skälet till att ett totalförbud misslyckas är att det mesta folk klistrar in är ofarligt, och förbudet lär dem att strunta i dig innan de kommer till den del som inte är det.
Offentligt
Allt som redan är publicerat: din egen marknadsföringstext, en offentlig FAQ, ett pressmeddelande, öppen dokumentation. Vilket verktyg som helst, vilket konto som helst. Det finns inget att läcka.
Internt
Färdplaner, utkast, interna nyckeltal, mötesanteckningar utan personuppgifter om tredje part. Inget GDPR-problem, men verklig kommersiell skada om det kommer ut. Företagskonto, och kontrollera träningsklausulen, för en modell som tränats på din färdplan är en modell som går att fråga om den.
Konfidentiellt
Kundavtal, leverantörsvillkor, allt som omfattas av en sekretessklausul du har skrivit under, plus vanliga personuppgifter som namn, mejladresser och kontohistorik. Bara godkänt verktyg, under ett biträdesavtal, med träning undantagen. Det är i den här klassen som ”vi använde bara gratisversionen” blir ett samtal om att anmäla en personuppgiftsincident.
Reglerat
Hälsouppgifter, biometri, brottsregister, fackmedlemskap och allt som matar ett automatiserat beslut om en person, som att sålla jobbsökande. Ingen verktygsfråga. Det här kräver först en dokumenterad bedömning, och ofta är det ärliga svaret att processen inte alls borde automatiseras.
Skugg-AI är den verkliga risken, inte datacentret
Det mesta av företagsdatan når en AI-leverantör via en anställds privata konto en tisdagseftermiddag, inte genom ett upphandlingsbeslut. Att blockera domänen flyttar det till en mobil, där du varken kan se det eller logga det.
Lösningen är föga glamorös: godkänn ett verktyg, gör det lätt att nå och skriv ner vad som får matas in i det. Folk följer en regel som de kan komma ihåg. De tar sig runt en regel som kostar dem tjugo minuter och ett ärende, och den andra sortens regel är hur ett kundavtal hamnar i en konsumentchattbot.
Europeiska dataskyddsstyrelsens (EDPB) yttrande 28/2024 om AI-modeller är värt att läsa här, om inte annat för tonen: dess återkommande svar är att de här frågorna måste bedömas från fall till fall. Det är också den praktiska lärdomen. Det finns ingen inställning som får det här att försvinna, bara ett beslut som någon måste äga.
En AI-policy på en sida som du kan kopiera
Kort nog för att folk ska läsa den, konkret nog för att gå att följa. Byt ut verktygsnamnen och ägaren, behåll formen.
- Godkända verktyg. Namnge dem. Ett räcker. Allt annat kräver en förfrågan till ägaren som anges nedan, och förfrågan tar oftast en dag, inte ett kvartal.
- Vad som får matas in. Offentligt och internt material, fritt. Konfidentiellt material bara i det godkända verktyget. Reglerad data aldrig, utan skriftligt godkännande.
- Vad som aldrig får matas in. Inloggningsuppgifter, API-nycklar, personuppgifter om sökande eller patienter, allt som omfattas av tystnadsplikt, och allt som du inte skulle skicka i ett mejl till fel adress.
- Kontrollera resultatet. Modeller har fel med stor övertygelse. Den som använde verktyget äger resultatet, precis som man äger en kalkylbladsformel man inte kontrollerade.
- Säg när du har använt det. Ingen bikt, bara en rad i dokumentet där AI skrev ett utkast som en kollega kommer att förlita sig på.
- Rapportera misstag utan dramatik. Om konfidentiellt material hamnade där det inte borde, säg det till ägaren samma dag. Ett tyst misstag blir en sen incidentanmälan, och det är den dyra sorten.
- Vem som äger det här. Ett namn, en mejladress, ett datum för översyn. En policy utan ägare förfaller till en wikisida som ingen har öppnat sedan introduktionen.
Skriv ut den, lägg den i personalhandboken, ägna femton minuter åt den på ett teammöte. Det är en större vinst för regelefterlevnaden än något leverantörsformulär.
Vad som ändras med en europeisk leverantör, och vad som inte gör det
Det kortar ett samtal. Om inferensen sker på infrastruktur inom Europeiska unionen slutar överföringsanalysen att vara det svåraste stycket i din dokumentation, och frågan ”vart tar den här datan vägen” får ett kort svar som du kan skriva i en integritetspolicy. Den fullständiga vägen för en förfrågan är värd att förstå en gång, eftersom det också är formen på svaret du ger dina egna kunder.
Det ändrar ingenting i de tre andra villkoren. Du behöver fortfarande en rättslig grund, ett skriftligt avtal, ett svar om lagringstid och en policy som folk följer. Och det gör inte leverantörens egen kedja europeisk som genom ett trollslag: vår är publicerad i sin helhet, inklusive de tre parterna med ett moderbolag i USA, eftersom en lista som döljer dem är marknadsföring snarare än transparens. Vad ordet suverän faktiskt är värt, lager för lager, plockar vi isär i europeisk suverän AI.
Fem kontroller innan du godkänner ett verktyg
Gör dem före pilotprojektet, inte efter utrullningen. De tar en eftermiddag.
- Hitta personuppgiftsbiträdesavtalet. Finns det inget är verktyget uteslutet för allt utom offentligt material.
- Sök i villkoren efter ”train”. Läs varje träff, också de om ”service improvement”, som ofta är samma sak i finare kläder.
- Be om listan över underbiträden. Med regioner och juridiska personer. Räkna sedan moderbolagen utanför EU, inte för att diskvalificera dem utan för att känna till antalet.
- Fråga vad som händer med en prompt efter svaret. Hur länge den sparas, vem som kan se den, och om du kan stänga av det.
- Kontrollera vad din egen integritetspolicy skulle behöva säga. Kan du inte skriva det stycket ärligt har du ditt svar, och det kom före avtalet i stället för efter.
Inget av det här kräver en jurist i första vändan. Det kräver någon med en eftermiddag och en vana att läsa klausulen i stället för landningssidan. När ett verktyg klarar de fem är den återstående frågan vilken sorts leverantör du alls vill ha, och de fyra realistiska alternativen jämförs i europeiska AI-leverantörer jämförda.
Vanliga frågor
Följer ChatGPT GDPR?
Ett verktyg följer eller bryter inte mot reglerna på egen hand; det är behandlingen du gör med det som gör det. En företagsplan med ett undertecknat personuppgiftsbiträdesavtal, en klausul mot träning och en bestämd lagringstid kan användas i enlighet med GDPR. Ett privat konto som används för kunddata, där ingen har läst villkoren, kan det oftast inte.
Får jag lägga in kunddata i en AI-chattbot?
Bara om du har en rättslig grund, ett personuppgiftsbiträdesavtal med leverantören och en klausul som säger att det du matar in inte används för träning. Även då ska du hålla känsliga personuppgifter som hälsouppgifter eller biometriska uppgifter borta, om inte en konsekvensbedömning avseende dataskydd säger något annat.
Får jag använda ett gratis ChatGPT-konto på jobbet?
För offentligt eller redan publicerat material går det oftast bra. För allt som är internt, konfidentiellt eller personligt är det fel verktyg: konsumentvillkor tillåter ofta träning på det du matar in, erbjuder inget biträdesavtal och ger din organisation ingen kontroll över lagringstiden.
Vad är skugg-AI?
Skugg-AI (shadow AI) är när anställda använder AI-verktyg som organisationen inte har godkänt, oftast på privata konton. Det är det vanligaste sättet som företagsdata hamnar hos en AI-leverantör, och att blockera verktyg brukar öka det snarare än minska det. Ett godkänt verktyg plus en kort skriftlig policy fungerar bättre.
Måste vi berätta för folk att vi använder AI på deras uppgifter?
I de flesta fall ja. GDPR:s krav på transparens betyder att din integritetspolicy bör ange att en AI-leverantör behandlar personuppgifter för din räkning, och AI-förordningen lägger till en egen skyldighet att tala om för människor när de interagerar med ett AI-system och inte med en person.
Får advokater eller revisorer använda ChatGPT med klientakter?
Bara efter att ha kontrollerat två saker som ligger ovanpå GDPR: tystnadspliktsreglerna från din egen tillsynsmyndighet eller ditt samfund, och sekretessklausulerna i dina uppdragsavtal med klienter. Båda kräver oftast ett biträdesavtal, en klausul mot träning och ett dokumenterat beslut om vilka typer av akter som alls får användas. Det är en fråga för din branschorganisation, inte för en leverantörs marknadsföringssida.
Får vi använda AI för att sålla bland jobbsökande?
Var försiktig. GDPR begränsar beslut som enbart grundas på automatiserad behandling och som påverkar någon i betydande grad, och EU:s AI-förordning klassar användning vid rekrytering och i anställning som hög risk, vilket medför extra skyldigheter. Att använda AI för att hjälpa en människa att läsa ansökningar är något annat än att låta den avvisa folk, och det andra kräver en dokumenterad bedömning innan det kommer i närheten av produktion.