Precio por token de una API de IA: lo que pagas
Cuánto cuesta un millón de tokens, por qué la salida es más cara que la entrada y cuándo compensa una suscripción. Precios reales en euros, sin letra pequeña.
Pagar por token significa pagar el texto por volumen, y a dos tarifas distintas: una para los tokens que envías y otra, más alta, para los tokens que el modelo te devuelve. En Union AI eso va de 0,40 € por millón de tokens de entrada en el tier más barato a 12 € por millón de tokens de salida en el más potente, sin IVA. La API no lleva suscripción, ni mínimo mensual, ni facturas que no hayas generado tú.
Lo incómodo es que un millón de tokens no es una unidad que nadie pueda imaginarse. Este artículo lo convierte en cifras que sí se entienden, con los mismos precios con los que mide nuestro router.
¿Cuánto cuesta un millón de tokens?
Aquí tienes la lista de precios completa. Cuatro tiers, dos tarifas cada uno, en euros y sin IVA.
| Tier | Para qué sirve | Entrada por 1 M | Salida por 1 M | Contexto |
|---|---|---|---|---|
| Lite | Clasificación, extracción, respuestas cortas | 0,40 € | 1,60 € | 131.000 tokens |
| Standard | El tier para todo: chat y la mayor parte del tráfico de la API | 0,70 € | 3,50 € | 262.000 tokens |
| Contexto largo | Expedientes enteros, contratos, bases de código | 1,00 € | 2,00 € | 1 millón de tokens |
| Pro | Razonamiento exigente, agentes, código complejo | 4,00 € | 12,00 € | 1 millón de tokens |
Hay dos cosas en esa tabla que sorprenden. El tier de contexto largo es más barato en salida que el tier para todo, porque un modelo pensado para leer un millón de tokens no es necesariamente el que mejor razona. Y entre el tier más barato y el más caro hay un factor de diez, lo que significa que elegir tier mueve tu factura mucho más de lo que lo hará nunca afinar los prompts.
La tabla completa, con una calculadora y una comparación con los proveedores estadounidenses a precio de lista, está en la página de precios. Qué modelo open-weight hay detrás de cada tier, y con qué licencia, lo encontrarás en la página de transparencia de la IA.
¿Cuántos tokens tiene una página, un mensaje, una base de código?
Un token es un fragmento de texto que el modelo lee o escribe, normalmente una palabra común o parte de una. La regla aproximada para el inglés es que mil tokens equivalen a unas 750 palabras. Otros idiomas se tokenizan con menos eficiencia, así que el mismo texto en neerlandés, finés o polaco cuesta un poco más.
Algunas referencias para aterrizar la abstracción:
- Una pregunta corta con un párrafo de respuesta: unos 300 tokens de entrada y 200 de salida.
- Un mensaje medio, con algo de contexto y una respuesta elaborada: unos 900 de entrada y 500 de salida. Es la suposición que hay detrás de todas las cifras de nuestra página de precios.
- Un contrato de 40 páginas: alrededor de 20.000 tokens de entrada. Resumirlo en el tier Standard cuesta una fracción de céntimo.
- Una base de código mediana, pongamos 5000 líneas: cabe holgadamente en la ventana de 262.000 tokens del tier Standard, y queda muy lejos del millón del tier de contexto largo.
Pasa el mensaje medio por el tier Standard y te salen 2,38 € por cada mil mensajes. Es la cifra que merece la pena memorizar, porque cambia toda la pregunta: para la mayoría de los equipos, el modelo no es la parte cara del producto.
¿Por qué la salida es más cara que la entrada?
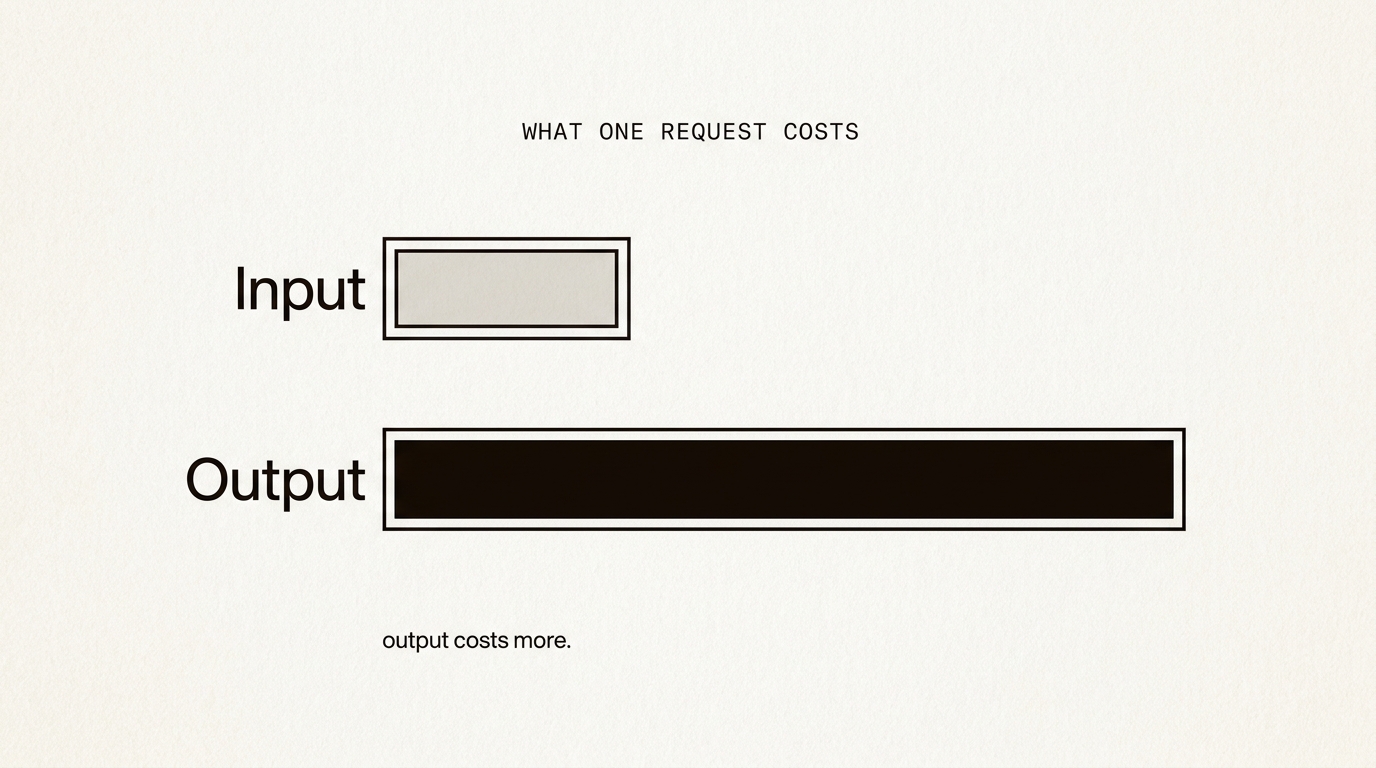
Porque escribir es un trabajo más lento que leer. Los tokens de entrada atraviesan el modelo en una sola pasada en paralelo, así que un prompt largo cuesta más o menos lo que sugiere su longitud, y nada más. Los tokens de salida salen de uno en uno, cada uno condicionado por el anterior, y el hardware permanece ocupado durante toda la secuencia. La tarifa de salida más alta es ese tiempo en serie.
La consecuencia práctica es un hábito que conviene adquirir: limita la salida, no la entrada. Pegar un documento entero en el prompt suele ser barato. Pedir una respuesta de mil palabras cuando bastaban cien es lo que de verdad aparece en la factura. Fijar max_tokens es el control de costes más eficaz de la API, y ocupa una línea.
Plan de chat
13,00 €
13 € al mes, 2000 mensajes incluidos en este tier, el resto con crédito.
API, por token
4,76 €
0,70 € de entrada y 3,50 € de salida por millón de tokens, sin cuota fija.
Aquí sale más barata la API, por 8,24 € al mes.
Este mensaje medio son 900 tokens de entrada y 500 de salida, las mismas suposiciones que usa la página de precios. Ambas cifras son sin IVA, y la comparación es solo de dinero: el plan incluye además una interfaz, archivos adjuntos y conversaciones compartidas, que los tokens por sí solos no te dan.
¿Sale más barato el pago por uso que una suscripción?
Con poco volumen, casi siempre. Unos cientos de mensajes al mes a través de la API cuestan bastante menos de un euro en el tier Standard, mientras que cualquier suscripción cobra la misma cuota fija la uses o no. Por debajo de mil mensajes al mes, el pago por token gana de calle.
La situación se invierte en tres casos, que puedes comprobar tú mismo con la comparación de arriba:
- Mensajes largos. Un prompt de cuatro mil tokens con una respuesta larga cuesta varias veces lo que un mensaje medio, y la cuota fija deja de parecer absurda.
- El tier caro. Una respuesta de Pro cuesta unas cuatro veces lo que una de Standard si la pagas con crédito, y cuenta como cinco mensajes dentro del cupo mensual del plan de chat.
- Quieres el producto, no la tubería. Nuestro plan de chat cuesta 13 € al mes, u 11 € al mes si pagas el año por adelantado, e incluye interfaz, archivos adjuntos, documentos largos y conversaciones compartidas. Construir eso tú mismo sobre la API te cuesta más de 13 € de tu propio tiempo la primera tarde.
Una suscripción es una apuesta sobre lo caro que acabará siendo tu mensaje medio. Pagar por token es negarse a apostar.
Ningún modelo es más honesto que el otro. Lo que hace honesto un precio es que puedas predecirlo antes de comprometerte, y por eso nuestro estimador explica sus suposiciones en lugar de mostrar una cifra mensual de aspecto amable.
Lo que esconde el precio por token
Cuatro cosas hacen que la factura real se aleje de la aritmética. Ninguna es un truco, y todas pillan a la gente desprevenida.
El historial de la conversación se reenvía en cada turno
Una llamada a la API no guarda estado. El turno diez de una conversación envía también los turnos uno a nueve, así que los tokens de entrada crecen con la longitud del hilo. Un chat largo puede gastar más en releer su propio historial que en cualquier cosa nueva. Recortar o resumir los turnos antiguos no es optimización prematura: es la palanca principal.
Los reintentos y los agentes multiplican las peticiones
Una sola acción del usuario en un bucle de agente puede suponer veinte llamadas al modelo. Multiplica el coste por petición por el bucle, no por el usuario. Y comprueba qué pasa si el bucle no termina, que es para lo que sirven los topes de la sección siguiente.
Las tarifas de portada no son toda la lista de precios
Los proveedores publican descuentos para entrada en caché, trabajos por lotes y gasto comprometido. Existen de verdad, y significan que una comparación solo vale si ambos lados se citan a la tarifa estándar. Nuestra tabla comparativa usa precios de lista en ambos lados precisamente por eso, con el tipo de cambio y la fecha en que se consultó impresos debajo, y las mismas cifras se desglosan proveedor por proveedor en proveedores europeos de IA comparados.
El trabajo fallido también cuesta, salvo que alguien decida lo contrario
Si un modelo devuelve algo inservible, la mayoría de los contadores ya han sumado los tokens. Nosotros lo vemos al revés: una petición que no produjo una respuesta útil no descuenta nada de tu saldo, y una petición redirigida que acaba en un modelo más débil se cobra a la más baja de las dos tarifas. La documentación enumera las cabeceras que te indican cuál de las dos cosas ha pasado.
¿Pago IVA por el crédito prepago de IA?
Depende de quién seas y de dónde estés. Si eres una empresa de otro país de la UE con un número de IVA válido, se aplica la inversión del sujeto pasivo: no añadimos IVA y lo declaras tú. La guía de la Comisión Europea sobre el IVA transfronterizo en servicios lo dice claramente: los clientes pagan el IVA de los servicios recibidos al tipo de su propio país mediante el procedimiento de inversión del sujeto pasivo.
Si no tienes un número de IVA válido, o compras como particular, se aplica el IVA al tipo de donde estés. Todos los precios de este sitio se indican sin IVA, y tu factura dice cuál de los dos tratamientos se ha aplicado.
Cómo evitar que se dispare la factura de tokens
El fallo nunca es el precio por millón. Es un bucle, una clave filtrada o un trabajo que ha estado corriendo todo el fin de semana. Cinco defensas, en el orden en que conviene configurarlas:
- Pon un tope por clave, en euros, diario y mensual. Una clave sin tope es un cheque en blanco.
- Fija
max_tokensen cada llamada. Mira la tarifa de salida de arriba. - Lee
X-EU-Cost-EURen la respuesta. Cada petición te dice cuánto ha descontado de tu saldo, así que tus propios logs pueden responder la pregunta del coste sin necesidad de un panel. - Mantén el saldo bajo. El crédito prepago tiene un suelo firme en cero, y eso es una ventaja. Una recarga de 10 € no puede convertirse en una sorpresa de 4000 €.
- Deja que la detección de anomalías haga su trabajo. Si vemos más de diez veces tu media semanal en una hora, pausamos la clave y te enviamos un correo. Las cuentas nuevas tienen un tope de 25 € al día durante las primeras 48 horas, sea cual sea el saldo.
Esto último provoca alguna falsa alarma de vez en cuando. Creemos que un trabajo por lotes interrumpido es mejor resultado que una cartera vacía, y puedes levantar el tope tú mismo en cuanto sepas que el tráfico es tuyo.
Lo que cuesta empezar
Diez peticiones a la API son gratis, la recarga mínima es de 10 € y el crédito es válido durante 24 meses. No hace falta tarjeta para probar el chat, que te da 5 mensajes gratis antes de pedirte nada.
Pasar una integración existente para ver esas cifras con tu propio tráfico es cuestión de una clave, una base URL y un nombre de tier, que es el tema de cambiar en tres líneas.
Esa es toda la parte comercial. Si quieres la otra mitad, dónde se procesan esos tokens y quién puede leerlos por el camino, el artículo complementario sobre residencia de datos de IA en la UE sigue la misma petición salto a salto, y IA soberana europea analiza cuánto vale la palabra soberana cuando la desmontas.
Preguntas frecuentes
¿Cuánto cuesta un millón de tokens?
Depende del modelo y de si los tokens entran o salen. En Union AI, un millón de tokens de entrada cuesta entre 0,40 y 4 euros según el tier, y un millón de tokens de salida entre 1,60 y 12 euros, sin IVA. La salida es siempre la mitad más cara, en todos los proveedores.
¿Qué es un token en una API de IA?
Un token es un fragmento de texto que el modelo lee o escribe, normalmente una palabra común o un trozo de una. Como regla aproximada para el inglés, mil tokens son unas 750 palabras, así que una página A4 de prosa ronda los 500 tokens. La facturación cuenta por separado los tokens que envías y los que genera el modelo.
¿Por qué la salida es más cara que la entrada?
Porque generar texto es un trabajo más lento que leerlo. Los tokens de entrada se procesan en una sola pasada en paralelo, mientras que los de salida se producen uno detrás de otro, y cada uno espera al anterior. Esa diferencia en tiempo de cómputo es lo que paga la tarifa de salida más alta.
¿Sale más barato el pago por uso que una suscripción de IA?
Con poco volumen, casi siempre. Unos cientos de mensajes al mes a través de una API suelen costar menos de un euro, mientras que una suscripción cobra una cuota fija la uses o no. La suscripción gana cuando tus mensajes son largos, cuando usas el modelo caro o cuando quieres una interfaz terminada en lugar de una API.
¿Cuántos tokens tiene un documento de 40 páginas?
Unos 20.000 tokens de entrada para 40 páginas de prosa normal, con la regla de unas 750 palabras por cada mil tokens. En un tier intermedio, leerlo cuesta una fracción de céntimo, y por eso una entrada larga rara vez es lo que dispara una factura de IA.
¿Por qué mi factura de IA ha crecido más rápido que mi uso?
Casi siempre porque el historial de la conversación se reenvía en cada turno. Una llamada a la API no guarda estado, así que el turno diez arrastra los turnos uno a nueve, y los tokens de entrada crecen con la longitud del hilo y no con el número de usuarios. Los bucles de agentes hacen lo mismo y convierten una sola acción del usuario en veinte peticiones facturadas.
¿Cómo calculo el coste de un LLM antes de construir nada?
Toma una petición realista, cuenta por separado sus tokens de entrada y de salida y multiplica por el volumen que esperas con las tarifas por millón del proveedor. Luego duplica la cifra de salida como margen de seguridad y suma todo lo que tu diseño reenvía, como el historial del chat o los documentos recuperados. Esa estimación suele acertar el orden de magnitud, que es todo lo que necesita una decisión de desarrollo.