IA soberana europea: qué significa en la práctica
La IA soberana son cuatro preguntas: el edificio, el operador, los pesos y los valores. Qué puede responder Europa hoy y qué puedes hacer este trimestre.
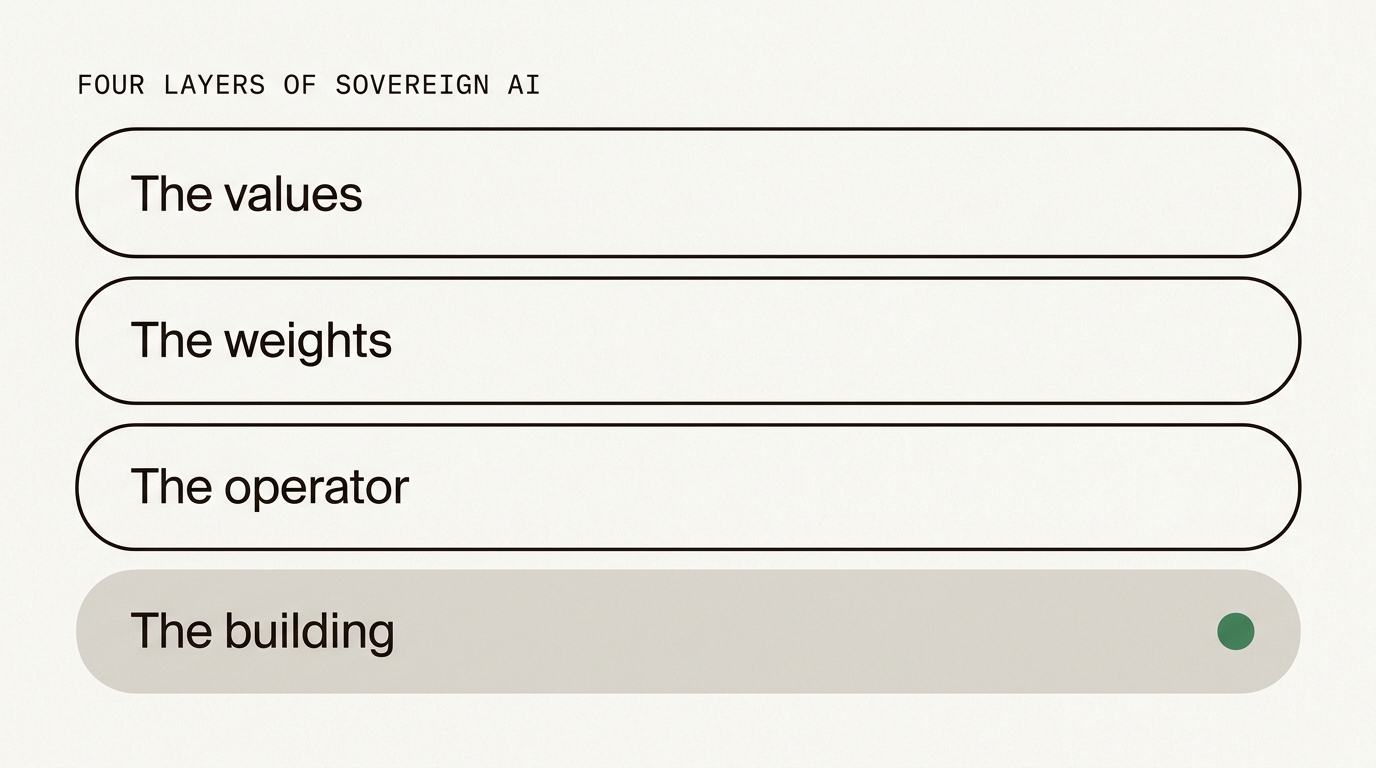
La IA soberana no es una sola propiedad. Son cuatro preguntas apiladas: dónde está el hardware, qué Estado puede obligar a la empresa que lo opera, quién entrenó el modelo y qué supuestos lleva dentro el modelo. Europa puede responder bien a la primera, a la segunda con matices y a la tercera y la cuarta solo en parte. Quien te vende las cuatro en una sola palabra te está vendiendo una aspiración.
Merece la pena decirlo claro antes de que entre en la conversación cualquier producto, incluido el nuestro. La versión útil de este debate no es «europeo o estadounidense». Es: ¿qué capa de la pila necesita de verdad esta carga de trabajo concreta y cuánto cuesta mover esa capa?
Qué significa de verdad la IA soberana
La palabra llegó desde el debate sobre capacidad de cómputo, donde tenía un significado preciso: un Estado debería poder ejecutar sistemas críticos sin permiso de otro Estado. Aplicada a la IA, se estiró hasta abarcar desde el código postal del centro de datos hasta la inclinación política de un chatbot, y por el camino perdió casi toda su utilidad.
Si la vuelves a dividir en partes, cada una se puede comprobar.
La soberanía no es una insignia en una landing page. Son cuatro preguntas con cuatro respuestas distintas, y los proveedores honestos te dicen a cuáles responden.
El edificio es geografía: en qué país está el hardware. El operador es jurisdicción: qué sistema jurídico vincula a la empresa que hace funcionar ese hardware. Los pesos son procedencia: quién entrenó el modelo, con qué datos y bajo qué licencia. Los valores son comportamiento: qué dice el modelo, a qué se niega y en qué se equivoca sin hacer ruido sobre tu parte del mundo.
Quién puede aportar cada capa en Europa hoy
| Capa | La pregunta | Europa hoy |
|---|---|---|
| El edificio | ¿Dónde está el hardware? | Resuelto. La capacidad europea es real y se puede contratar |
| El operador | ¿Qué Estado puede obligar al operador? | Disponible para inferencia, más difícil para hosting, bases de datos y pagos |
| Los pesos | ¿Quién entrenó el modelo? | Escaso pero mejorando, con un déficit de cómputo que se está cubriendo ahora |
| Los valores | ¿Qué dirá el modelo y a qué se negará? | En parte, y sobre todo mediante documentación más que mediante entrenamiento |
Las capas se complican a medida que subes, y el precio de cada una sube con ellas. Alquilar cómputo europeo es una decisión de compras. Entrenar en Europa un modelo de frontera competitivo es un proyecto industrial de varios años, que es justo para lo que sirve la actual oleada de financiación de la UE.
¿Dónde está físicamente el hardware?
- Lo que Europa puede aportar hoy
- Resuelto. La capacidad de centros de datos europea es real, se puede contratar y crece.
- Lo que hace Union AI
- Toda la inferencia de IA se ejecuta en infraestructura dentro de la Unión Europea.
Un punto verde de cuatro. Cualquier proveedor que diga cubrir las cuatro hoy está describiendo una aspiración, no una pila que puedas comprar.
¿Hay LLM europeos que merezca la pena usar?
Sí, y la imagen honesta es la de un campo joven, no terminado. Se divide en dos tipos de esfuerzo.
El primero es comercial. Laboratorios europeos publican modelos open-weight que puedes descargar y ejecutar tú mismo, y sus modelos más pequeños son realmente competitivos para el trabajo diario. Esta es la parte de la pila europea que ya funciona hoy en producción.
El segundo es público. OpenEuroLLM es un consorcio de universidades, centros de supercomputación y empresas europeas, financiado a través del programa Europa Digital, que construye modelos fundacionales abiertos para las lenguas oficiales de la UE y publica sus datos, su código y sus evaluaciones junto con los pesos. Esa última parte importa más que las puntuaciones del modelo: un modelo cuyos datos de entrenamiento y evaluaciones son públicos es un modelo que puedes auditar, y casi nada en la frontera es auditable hoy.
Por debajo de ambos está el cómputo. El programa de gigafactorías de IA de la Comisión moviliza 20.000 millones de euros a través del mecanismo InvestAI para capacidad de entrenamiento a gran escala en Europa, y la convocatoria informal de manifestaciones de interés recibió 77 propuestas de 16 Estados miembros y 60 emplazamientos, con la construcción del primero prevista a partir de 2027. Si eso cerrará la brecha de capacidades es una pregunta abierta. Lo que sí significa es que la respuesta en 2029 no será la de hoy, y eso es un motivo para mantener tu pila portable, no para esperar.
¿Se puede entrenar un modelo con valores europeos?
En parte, y la expresión merece más escrutinio del que suele recibir. «Entrenado con valores europeos» hace tres trabajos distintos, y solo dos se pueden comprobar.
La lengua es un valor, y se puede medir
Un modelo que maneja el neerlandés, el finés, el griego y el portugués tan bien como el inglés es, para los usuarios europeos, un producto distinto de uno que los trata como algo secundario. La cobertura lingüística se prueba en una tarde: lanza tus propios prompts, en tus propias lenguas, y compara. Es la prueba más útil de todo el debate sobre soberanía, y casi nadie la hace antes de comprar.
La forma de negarse revela el entrenamiento
Algunos modelos open-weight se entrenan bajo sistemas jurídicos con sus propias sensibilidades, y esquivan preguntas factuales sobre política o historia que un usuario europeo consideraría de lo más normales. Lo tratamos como un defecto, no como una función de seguridad. Cuando nuestro sistema detecta ese tipo de negativa en la primera frase de una respuesta, cancela la respuesta y vuelve a lanzar la pregunta en un modelo sin ese punto ciego, como mucho una vez por petición, y te lo indica en la cabecera X-EU-Routed. Lo que no hacemos es esquivar las negativas de seguridad legítimas: esas siguen denegadas, porque redirigir hasta que un modelo acceda es un jailbreak automatizado.
Todo lo demás es documentación, no entrenamiento
El resto de lo que la gente entiende por valores, que un modelo sea justo, equilibrado y adecuado, no es algo que puedas verificar en una página comercial. Lo que sí puedes verificar es si el proveedor publica el modelo, la licencia, el system prompt y la tasa de negativas medida. Nosotros publicamos las cuatro cosas en nuestra página de transparencia de la IA, incluidas las partes que nos dejan peor.
¿La seguridad de los datos exige un modelo europeo?
No, y confundir las dos cosas les cuesta dinero de verdad a los equipos. Dónde se entrenó un modelo y dónde se procesa tu prompt son hechos independientes.
Los pesos son un archivo. Descarga un modelo open-weight, ejecútalo en hardware europeo, y tu prompt va a ese hardware y vuelve, lo haya entrenado quien lo haya entrenado. Lo que viaja con los pesos es el comportamiento, no el flujo de datos. Por eso nuestra pila puede ser honesta sobre el hecho de que usa sobre todo modelos no europeos y aun así procesar cada petición dentro de la Unión Europea, y por eso el recorrido de la petición importa más para la protección de datos que la historia de origen del modelo.
Las cuatro preguntas de seguridad de datos que conviene hacer a cualquier proveedor, europeo o no: dónde se procesa la inferencia, cuánto tiempo se conservan los prompts, si se usan para entrenar y qué empresas de la cadena tienen una matriz fuera de la UE. Las nuestras están respondidas en la página de subencargados, incluidas las incómodas.
Qué puedes hacer de verdad este trimestre
La soberanía como decisión de compra fracasa, porque nada en el mercado supera las cuatro capas. La soberanía como una secuencia de pasos pequeños funciona. Más o menos por orden de rendimiento:
- Clasifica las cargas de trabajo antes que los proveedores. La mayoría de los equipos tiene una parte de tráfico realmente sensible y una gran mayoría corriente. Conocer la proporción cambia qué compromisos merece la pena pagar.
- Mueve primero la parte sensible. Contratos con clientes, expedientes de RR. HH., notas de pacientes, código sin publicar. Deja donde está el resumen de páginas web públicas.
- Pide por escrito la lista de subencargados y la cláusula de entrenamiento. No una llamada comercial. Una lista con regiones y entidades jurídicas, más una búsqueda de la palabra «train» en las condiciones.
- Mantén aburrida la interfaz. Una API compatible con OpenAI vale más que cualquier promesa de soberanía, porque hace que cambiar sea barato. La portabilidad es la única palanca que sobrevive a que un proveedor cambie de opinión. La nuestra está documentada en la referencia de la API, y lo que implica de verdad un cambio está en cambiar en tres líneas.
- Registra pruebas por petición. Una cabecera que indica el tier, el número de tokens y el coste convierte una afirmación en una pista de auditoría.
- Repite la prueba dentro de seis meses. El panorama de modelos europeos se mueve más rápido que cualquier ciclo de compras. Los supuestos del año pasado ya están caducados.
Nada de esto exige reconstruir nada, y todo sobrevive vaya hacia donde vaya el mercado.
Dónde encajamos y dónde no
Union AI es un servicio europeo que ejecuta modelos open-weight, con toda la inferencia de IA en infraestructura dentro de la Unión Europea, prepago en euros y con precio por token. Cubrimos por completo la capa inferior, la mayor parte de la capa del operador, y somos claros sobre las dos de arriba.
Nuestros modelos son open-weight con licencias Apache 2.0 y MIT, y la mayoría no se entrenó en Europa. El único modelo entrenado en Europa en nuestra pila hoy es el modelo de Mistral al que recurrimos en el tier más barato cuando falla el principal. Preferimos escribir esa frase a dejar que la palabra soberana haga el trabajo por nosotros.
Cómo queda eso frente a las otras tres formas de contratar IA en Europa, incluidas las filas en las que perdemos, está en proveedores europeos de IA comparados.
Así que la propuesta es estrecha a propósito. Si quieres que tus prompts se procesen en Europa, con un proveedor europeo, en modelos cuyo comportamiento está documentado y cuya factura es predecible, eso existe hoy y puedes empezar esta semana. Si quieres un modelo europeo de frontera entrenado con datos europeos, se está construyendo, con dinero público y un calendario publicado, y ni nosotros ni nadie te lo puede vender todavía.
Preguntas frecuentes
¿Qué es la IA soberana?
La IA soberana es la idea de que un país o una unión pueda ejecutar sistemas de IA que controla, en sus propios términos. En la práctica se divide en cuatro preguntas: dónde está el hardware, qué Estado puede obligar al operador, quién entrenó el modelo y qué valores refleja el modelo. La mayoría de los proveedores responde a una de las cuatro y usa la palabra para todas.
¿Necesito un LLM europeo para cumplir el Reglamento de IA de la UE?
No. El Reglamento de IA regula cómo se construyen, documentan y presentan a las personas los sistemas de IA, no dónde se entrenó el modelo. Un modelo open-weight estadounidense o chino puede usarse cumpliendo la norma, y un modelo europeo puede usarse incumpliéndola. El cumplimiento depende de tus obligaciones como proveedor o responsable del despliegue, no del pasaporte de los pesos.
¿Los modelos open-weight son lo mismo que el código abierto?
No, y la diferencia importa. Open-weight significa que puedes descargar y ejecutar el modelo por tu cuenta, normalmente con una licencia como Apache 2.0 o MIT. Código abierto en sentido pleno significaría además datos de entrenamiento publicados y código de entrenamiento reproducible, algo que la mayoría de los modelos open-weight no ofrece.
¿Puedo usar un modelo open-weight chino y mantener los datos en Europa?
Sí. Los pesos son un archivo. Cuando descargas un modelo y lo ejecutas en infraestructura europea, tus prompts van a ese hardware y a ningún otro sitio, lo haya entrenado quien lo haya entrenado. Lo que viaja con los pesos no son tus datos sino el comportamiento del modelo, incluidos los temas que se le entrenó para evitar.
¿Ejecutar un modelo en Europa hace que mis datos estén seguros?
Elimina un tipo de riesgo y deja otros. Significa que tus prompts se procesan en infraestructura europea en lugar de enviarse fuera, pero no dice nada de la conservación, del entrenamiento con tus entradas, de los controles de acceso ni de si el operador tiene una matriz fuera de la UE. Pregunta por las cuatro cosas por separado.
¿Qué significa que un modelo esté entrenado con valores europeos?
En la práctica significa tres cosas comprobables: que maneja bien las lenguas europeas, que responde a preguntas factuales sobre política e historia en lugar de esquivarlas y que sus datos de entrenamiento y su forma de negarse están documentados. No es un eslogan que puedas verificar, así que trátalo como una serie de pruebas que haces tú y no como una etiqueta en la que confías.
¿Qué proyectos de la UE están entrenando modelos de lenguaje europeos?
OpenEuroLLM es el más visible: un consorcio de universidades, centros de supercomputación y empresas europeas, financiado a través del programa Europa Digital, que construye modelos abiertos para las lenguas oficiales de la UE y publica sus datos y evaluaciones junto con los pesos. Por debajo, el programa de gigafactorías de IA de la Comisión moviliza 20.000 millones de euros a través del mecanismo InvestAI para la capacidad de entrenamiento que esos modelos necesitan.