IA souveraine européenne : ça veut dire quoi ?
L’IA souveraine, c’est quatre questions : le bâtiment, l’exploitant, les poids et les valeurs. Ce à quoi l’Europe sait répondre, et quoi faire ce trimestre.
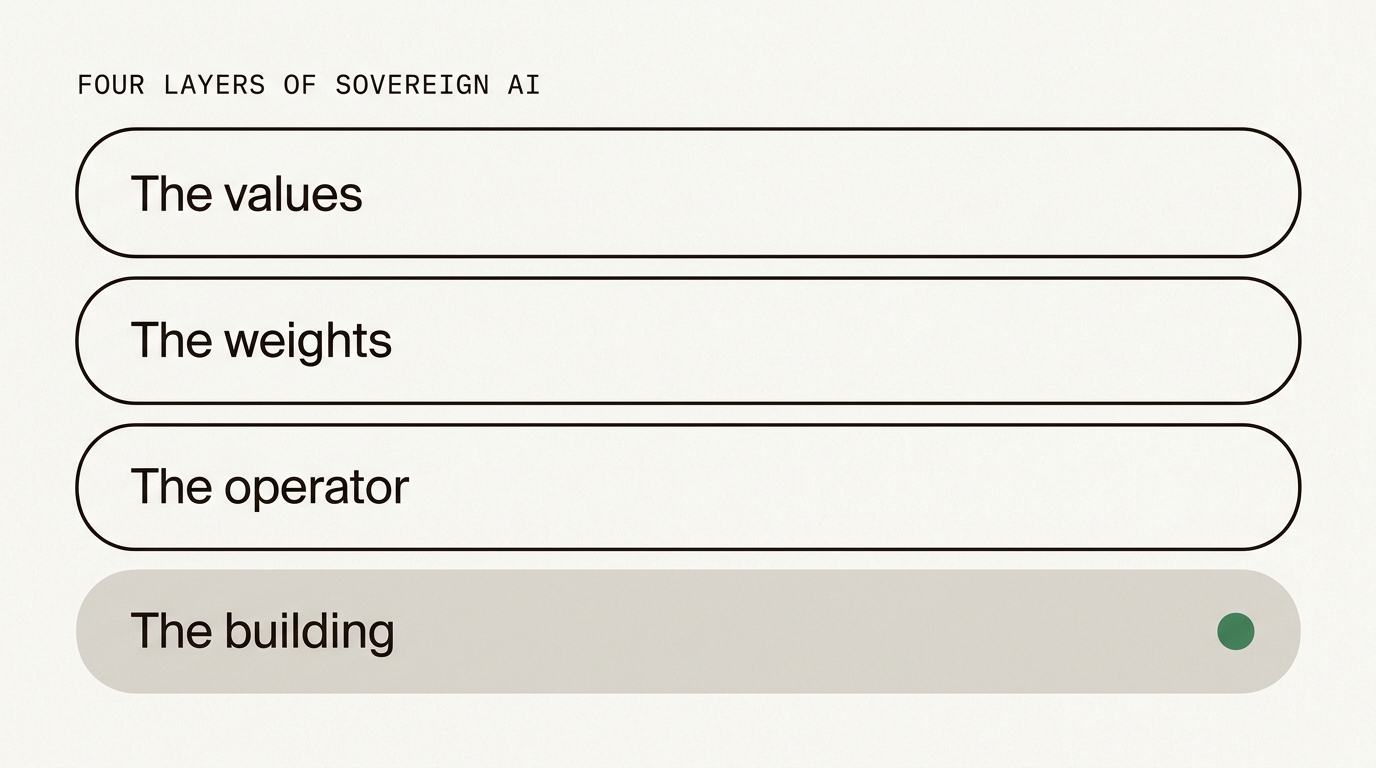
L’IA souveraine n’est pas une propriété unique. Ce sont quatre questions empilées : où se trouve le matériel, quel État peut contraindre l’entreprise qui l’exploite, qui a entraîné le modèle, et quelles hypothèses le modèle transporte. L’Europe répond bien à la première, à la deuxième avec des réserves, et aux deux dernières seulement en partie. Quiconque te vend les quatre en un seul mot te vend une ambition.
Autant le dire clairement avant qu’un produit n’entre dans la discussion, y compris le nôtre. La version utile de ce débat n’est pas « européen ou américain ». C’est : de quelle couche de la pile cette charge de travail a-t-elle réellement besoin, et combien coûte le déplacement de cette couche ?
Que veut vraiment dire IA souveraine ?
Le mot vient du débat sur la puissance de calcul, où il avait un sens précis : un État doit pouvoir faire tourner ses systèmes critiques sans la permission d’un autre État. Appliqué à l’IA, il s’est étiré pour tout couvrir, du code postal des datacenters aux penchants politiques d’un chatbot, et a perdu en route l’essentiel de son utilité.
Décompose-le à nouveau en parties, et chacune devient vérifiable.
La souveraineté n’est pas un badge sur une page d’accueil. Ce sont quatre questions avec quatre réponses différentes, et les fournisseurs honnêtes te disent auxquelles ils répondent.
Le bâtiment, c’est la géographie : dans quel pays se trouve le matériel. L’exploitant, c’est la juridiction : quel système juridique s’impose à l’entreprise qui fait tourner ce matériel. Les poids, c’est la provenance : qui a entraîné le modèle, sur quelles données, sous quelle licence. Les valeurs, c’est le comportement : ce que le modèle dit, ce qu’il refuse, et les erreurs qu’il commet discrètement sur ta partie du monde.
Qui peut fournir chaque couche en Europe aujourd’hui ?
| Couche | La question | L’Europe aujourd’hui |
|---|---|---|
| Le bâtiment | Où se trouve le matériel ? | Réglé. La capacité européenne est réelle et réservable |
| L’exploitant | Quel État peut contraindre l’exploitant ? | Disponible pour l’inférence, plus difficile pour l’hébergement, les bases de données et les paiements |
| Les poids | Qui a entraîné le modèle ? | Mince mais en progrès, avec un retard de calcul en cours de rattrapage |
| Les valeurs | Que dira et que refusera le modèle ? | En partie, surtout par la documentation plutôt que par l’entraînement |
Plus on monte, plus les couches sont difficiles, et plus chacune coûte cher. Louer de la puissance de calcul européenne est une décision d’achat. Entraîner en Europe un modèle de pointe compétitif est un projet industriel sur plusieurs années, et c’est précisément l’objet de la vague actuelle de financements européens.
Où se trouve physiquement le matériel ?
- Ce que l’Europe peut fournir aujourd’hui
- Réglé. La capacité des datacenters européens est réelle, réservable et en croissance.
- Ce que fait Union AI
- Toute l’inférence IA tourne sur une infrastructure située dans l’Union européenne.
Un point vert sur quatre. Tout fournisseur qui revendique les quatre aujourd’hui décrit une ambition, pas une pile que tu peux acheter.
Existe-t-il des LLM européens qui valent la peine ?
Oui, et le tableau honnête est celui d’un domaine jeune plutôt que d’un domaine abouti. Il se divise en deux types d’efforts.
Le premier est commercial. Des laboratoires européens publient des modèles open-weight que tu peux télécharger et faire tourner toi-même, et leurs petits modèles sont réellement compétitifs pour le travail quotidien. C’est la partie de la pile européenne qui fonctionne déjà en production aujourd’hui.
Le second est public. OpenEuroLLM est un consortium d’universités européennes, de centres de calcul haute performance et d’entreprises, financé par le programme pour une Europe numérique, qui construit des modèles de fondation ouverts couvrant les langues officielles de l’UE et publie ses données, son code et ses évaluations avec les poids. Ce dernier point compte plus que les scores des modèles : un modèle dont les données d’entraînement et les évaluations sont publiques est un modèle que tu peux auditer, et presque rien n’est auditable aujourd’hui à la pointe.
Sous les deux, il y a la puissance de calcul. Le programme de gigafactories d’IA de la Commission mobilise 20 milliards d’euros via le dispositif InvestAI pour une capacité d’entraînement à grande échelle en Europe, et l’appel informel à manifestation d’intérêt a reçu 77 propositions dans 16 États membres et 60 sites, avec une construction du premier site attendue à partir de 2027. Reste à savoir si ça comblera l’écart de capacités. En tout cas, la réponse en 2029 ne sera pas celle d’aujourd’hui, ce qui est une raison de garder ta pile portable plutôt que d’attendre.
Un modèle peut-il être entraîné sur les valeurs européennes ?
En partie, et l’expression mérite plus d’examen qu’on ne lui en accorde d’habitude. « Entraîné sur les valeurs européennes » remplit trois fonctions distinctes, et seules deux sont vérifiables.
La langue est une valeur, et elle se mesure
Un modèle qui gère le néerlandais, le finnois, le grec et le portugais aussi bien que l’anglais est un autre produit, pour des utilisateurs européens, qu’un modèle qui les traite en passant. La couverture linguistique se teste en un après-midi : fais tourner tes propres prompts, dans tes propres langues, et compare. C’est le test le plus utile de tout le débat sur la souveraineté, et presque personne ne le fait avant d’acheter.
Les refus révèlent l’entraînement
Certains modèles open-weight sont entraînés sous des systèmes juridiques qui ont leurs propres sensibilités, et ils esquivent des questions factuelles sur la politique ou l’histoire qu’un utilisateur européen jugerait parfaitement ordinaires. Nous considérons ça comme un défaut, pas comme une mesure de sécurité. Quand notre système détecte ce type de refus dans la première phrase d’une réponse, il annule la réponse et repose la question à un modèle qui n’a pas cet angle mort, au maximum une fois par requête, et te le signale dans l’en-tête X-EU-Routed. Ce que nous ne faisons pas, c’est contourner les vrais refus de sécurité : ceux-là restent des refus, parce que rerouter jusqu’à ce qu’un modèle obéisse revient à un jailbreak automatisé.
Tout le reste relève de la documentation, pas de l’entraînement
Le reste de ce qu’on entend par valeurs, qu’un modèle soit juste, équilibré et approprié, n’est pas vérifiable depuis une page marketing. Ce que tu peux vérifier, c’est si le fournisseur publie le modèle, la licence, le prompt système et le taux de refus mesuré. Nous publions les quatre sur notre page de transparence de l’IA, y compris ce qui nous montre sous un moins bon jour.
La sécurité des données exige-t-elle un modèle européen ?
Non, et confondre les deux coûte de l’argent aux équipes. L’endroit où un modèle a été entraîné et l’endroit où ton prompt est traité sont deux faits indépendants.
Les poids sont un fichier. Télécharge un modèle open-weight, fais-le tourner sur du matériel européen, et ton prompt va vers ce matériel et en revient, quel que soit celui qui l’a entraîné. Ce qui voyage avec les poids, c’est le comportement, pas le flux de données. C’est pour ça que notre pile peut dire honnêtement qu’elle fait tourner surtout des modèles non européens tout en traitant chaque requête dans l’Union européenne, et pour ça que le trajet d’une requête compte plus pour la protection des données que l’origine du modèle.
Les quatre questions de sécurité des données à poser à tout fournisseur, européen ou non : où l’inférence est-elle traitée, combien de temps les prompts sont-ils conservés, servent-ils à l’entraînement, et quels acteurs de la chaîne ont une maison mère hors de l’UE. Nos réponses sont sur la page des sous-traitants ultérieurs, y compris les plus gênantes.
Ce que tu peux concrètement faire ce trimestre
La souveraineté comme décision d’achat échoue, parce que rien sur le marché ne coche les quatre couches. La souveraineté comme suite de petits pas fonctionne. À peu près par ordre de rentabilité :
- Classe les charges de travail avant les fournisseurs. La plupart des équipes ont une petite part de trafic vraiment sensible et une large majorité de trafic ordinaire. Connaître la proportion change les compromis qui valent la peine d’être payés.
- Déplace d’abord la part sensible. Contrats clients, dossiers RH, notes sur des patients, code non publié. Laisse le résumé de pages web publiques là où il est.
- Demande par écrit la liste des sous-traitants ultérieurs et la clause sur l’entraînement. Pas un rendez-vous commercial. Une liste avec les régions et les entités juridiques, et une recherche du mot « entraînement » dans les conditions.
- Garde une interface banale. Une API compatible OpenAI vaut plus que n’importe quelle promesse de souveraineté, parce qu’elle rend le changement peu coûteux. La portabilité est le seul levier qui survit à un fournisseur qui change d’avis. La nôtre est documentée dans la référence de l’API, et ce qu’implique concrètement un changement est expliqué dans changer de fournisseur en trois lignes.
- Journalise des preuves par requête. Un en-tête qui indique le niveau, le nombre de tokens et le coût transforme une affirmation en piste d’audit.
- Refais le test dans six mois. Le paysage des modèles européens bouge plus vite que n’importe quel cycle d’achat. Les hypothèses de l’an dernier sont périmées.
Rien de tout ça n’exige de tout reconstruire, et tout ça résiste quelle que soit l’évolution du marché.
Où nous nous situons, et où non
Union AI est un service européen qui fait tourner des modèles open-weight, avec toute l’inférence IA sur une infrastructure située dans l’Union européenne, prépayée en euros et facturée au token. Nous couvrons entièrement la couche du bas, l’essentiel de la couche exploitant, et nous sommes transparents sur les deux couches du dessus.
Nos modèles sont open-weight, sous Apache 2.0 et MIT, et la plupart n’ont pas été entraînés en Europe. Le seul modèle entraîné en Europe dans notre pile aujourd’hui est le modèle Mistral vers lequel nous basculons sur le niveau le moins cher quand le modèle principal tombe en panne. Nous préférons écrire cette phrase plutôt que de laisser le mot souverain faire le travail à notre place.
Comment ça se compare aux trois autres façons d’acheter de l’IA en Europe, y compris sur les lignes où nous perdons, c’est dans les fournisseurs d’IA européens comparés.
L’argument est donc volontairement étroit. Si tu veux que tes prompts soient traités en Europe, par un fournisseur européen, sur des modèles au comportement documenté et avec une facture prévisible, ça existe aujourd’hui et tu peux commencer cette semaine. Si tu veux un modèle de pointe européen entraîné sur des données européennes, il est en construction, avec de l’argent public et un calendrier publié, et ni nous ni personne ne peut encore te le vendre.
Questions fréquentes
Qu’est-ce que l’IA souveraine ?
L’IA souveraine, c’est l’idée qu’un pays ou une union puisse faire tourner des systèmes d’IA qu’il contrôle, selon ses propres conditions. En pratique, elle se décompose en quatre questions : où se trouve le matériel, quel État peut contraindre l’exploitant, qui a entraîné le modèle, et de qui le modèle reflète les valeurs. La plupart des fournisseurs répondent à l’une des quatre et utilisent le mot pour toutes.
Faut-il un LLM européen pour respecter l’AI Act ?
Non. L’AI Act (règlement européen sur l’IA) encadre la façon dont les systèmes d’IA sont conçus, documentés et présentés aux personnes, pas l’endroit où le modèle a été entraîné. Un modèle open-weight américain ou chinois peut être utilisé de façon conforme, et un modèle européen de façon non conforme. La conformité dépend de tes obligations en tant que fournisseur ou déployeur, pas du passeport des poids.
Les modèles open-weight sont-ils la même chose que l’open source ?
Non, et la différence compte. Open-weight signifie que tu peux télécharger le modèle et le faire tourner toi-même, en général sous une licence comme Apache 2.0 ou MIT. L’open source au sens plein impliquerait aussi des données d’entraînement publiées et un code d’entraînement reproductible, ce que la plupart des modèles open-weight ne fournissent pas.
Puis-je utiliser un modèle open-weight chinois et garder mes données en Europe ?
Oui. Les poids sont un fichier. Une fois le modèle téléchargé et exécuté sur une infrastructure européenne, tes prompts vont vers ce matériel et nulle part ailleurs, quel que soit celui qui a entraîné le modèle. Ce qui voyage avec les poids, ce ne sont pas tes données mais le comportement du modèle, y compris les sujets qu’il a appris à éviter.
Faire tourner un modèle en Europe suffit-il à protéger mes données ?
Ça élimine une catégorie de risques et en laisse d’autres. Tes prompts sont traités sur une infrastructure européenne au lieu d’être envoyés à l’étranger, mais ça ne dit rien de la conservation, de l’entraînement sur tes données, des contrôles d’accès, ni du fait que l’exploitant ait ou non une maison mère hors de l’UE. Pose les quatre questions séparément.
Que signifie un modèle entraîné sur les valeurs européennes ?
En pratique, trois choses vérifiables : qu’il maîtrise bien les langues européennes, qu’il réponde aux questions factuelles sur la politique et l’histoire au lieu de les esquiver, et que ses données d’entraînement et ses refus soient documentés. Ce n’est pas un slogan vérifiable : traite-le comme une série de tests à faire toi-même, pas comme une étiquette à croire sur parole.
Quels projets européens entraînent des modèles de langue européens ?
OpenEuroLLM est le plus visible : un consortium d’universités européennes, de centres de calcul haute performance et d’entreprises, financé par le programme pour une Europe numérique, qui construit des modèles ouverts couvrant les langues officielles de l’UE et publie ses données et ses évaluations avec les poids. En dessous, le programme de gigafactories d’IA de la Commission mobilise 20 milliards d’euros via le dispositif InvestAI pour la capacité d’entraînement dont ces modèles ont besoin.