ChatGPT est-il conforme au RGPD en entreprise ?
Oui, sous conditions. Le type de compte, les clauses et les données décident de tout, avec une politique d’usage de l’IA d’une page que ton équipe suivra vraiment.
Oui, sous conditions, et tout se joue dans les conditions. Le RGPD ne certifie pas des outils, il encadre des traitements : le même chatbot peut être utilisé légalement par une équipe et illégalement par l’équipe d’à côté. Ce qui les sépare, c’est l’offre qu’elles ont achetée, l’existence ou non d’un accord de traitement des données, l’usage éventuel des contenus pour l’entraînement, et les données que les gens collent réellement.
Ce dernier point, la plupart des politiques internes le ratent. Personne dans ton entreprise ne décide « est-ce qu’on utilise l’IA » ; chacun décide, quarante fois par jour, si ce paragraphe-là peut aller dans la case. Une politique qui répond à cette question en une page vaut mieux qu’une revue achats qui ne répond à rien.
La réponse courte, et les quatre conditions
N’importe quel assistant IA peut faire partie d’un traitement conforme au RGPD si quatre conditions sont réunies en même temps.
- Une base légale pour le traitement sous-jacent, qu’il te fallait de toute façon. L’outil d’IA n’en crée pas et n’en supprime pas.
- Un accord de traitement avec le fournisseur au sens de l’article 28, parce que des données personnelles dans tes prompts font de lui un sous-traitant.
- Pas d’entraînement sur tes contenus, par écrit, dans les conditions que tu as réellement signées plutôt que dans un billet de blog du fournisseur.
- Une réponse sur la conservation : combien de temps les prompts sont gardés, par qui, et si tu peux la désactiver.
S’il en manque une, tu n’as pas un problème de conformité théorique ; tu as un paragraphe que tu ne peux pas écrire dans ta propre politique de confidentialité. C’est en général à ce moment-là que les équipes découvrent le trou.
Compte personnel ou compte entreprise : la différence qui compte
Les fournisseurs vendent le même modèle deux fois, à des conditions très différentes. Ce n’est pas le modèle qui change.
| Abonnement grand public | Offre entreprise ou API | |
|---|---|---|
| Accord de traitement | En général aucun | Standard, souvent en libre-service |
| Entraînement sur tes contenus | Souvent par défaut, parfois désactivable | Normalement exclu par contrat |
| Contrôle de la conservation | Aucun | Défini, parfois paramétrable |
| Qui est responsable | Le salarié qui s’est inscrit | Ton organisation |
| Adapté pour | Contenus publics, usage personnel | Données internes et clients, aux conditions ci-dessus |
Lis ton propre contrat plutôt que ce tableau, parce que les conditions bougent. La vérification prend dix minutes : ouvre les conditions, cherche « train » ou « entraînement », cherche « retention » ou « conservation », et cherche les mots « data processing agreement » ou « accord de traitement ». Si ces trois recherches ne donnent rien, tu es sur un produit grand public, quoi que dise la facture.
La conformité n’est pas une propriété de l’outil. C’est une propriété du montage entre toi, le fournisseur et les données que tu envoies.
Faut-il un DPA pour utiliser l’IA au travail ?
Si des données personnelles d’autres personnes se retrouvent dans tes prompts, oui. Tu es le responsable du traitement, le fournisseur d’IA est le sous-traitant, et l’article 28 exige que l’accord soit écrit. C’est vrai pour un outil de synthèse, pour un outil qui rédige des réponses au support et pour un assistant de code qui voit par hasard le nom d’un client dans une trace d’erreur.
Le nôtre est résumé sur la page DPA et le texte à signer est à un e-mail de distance, sans rendez-vous commercial, et c’est un bon niveau d’exigence à appliquer à n’importe quel fournisseur : si les conditions n’apparaissent qu’une fois que tu es dans un processus d’achat, cela en dit long sur la fréquence à laquelle elles changent.
Deux choses qu’on attend d’un DPA et qu’il ne fait pas. Il ne te donne pas de base légale. Et il ne rend pas sûr le fait de coller des données sensibles ; les données de santé, biométriques et assimilées demandent leur propre analyse, et les recommandations de la CNIL sur l’IA et le RGPD sont un point de départ raisonnable pour savoir ce que cette analyse doit couvrir.
Public
N’importe quel outil, même un compte gratuit.
Elle est déjà publique. Rien de ce que tu colles ne peut divulguer ce que tout le monde peut déjà lire.
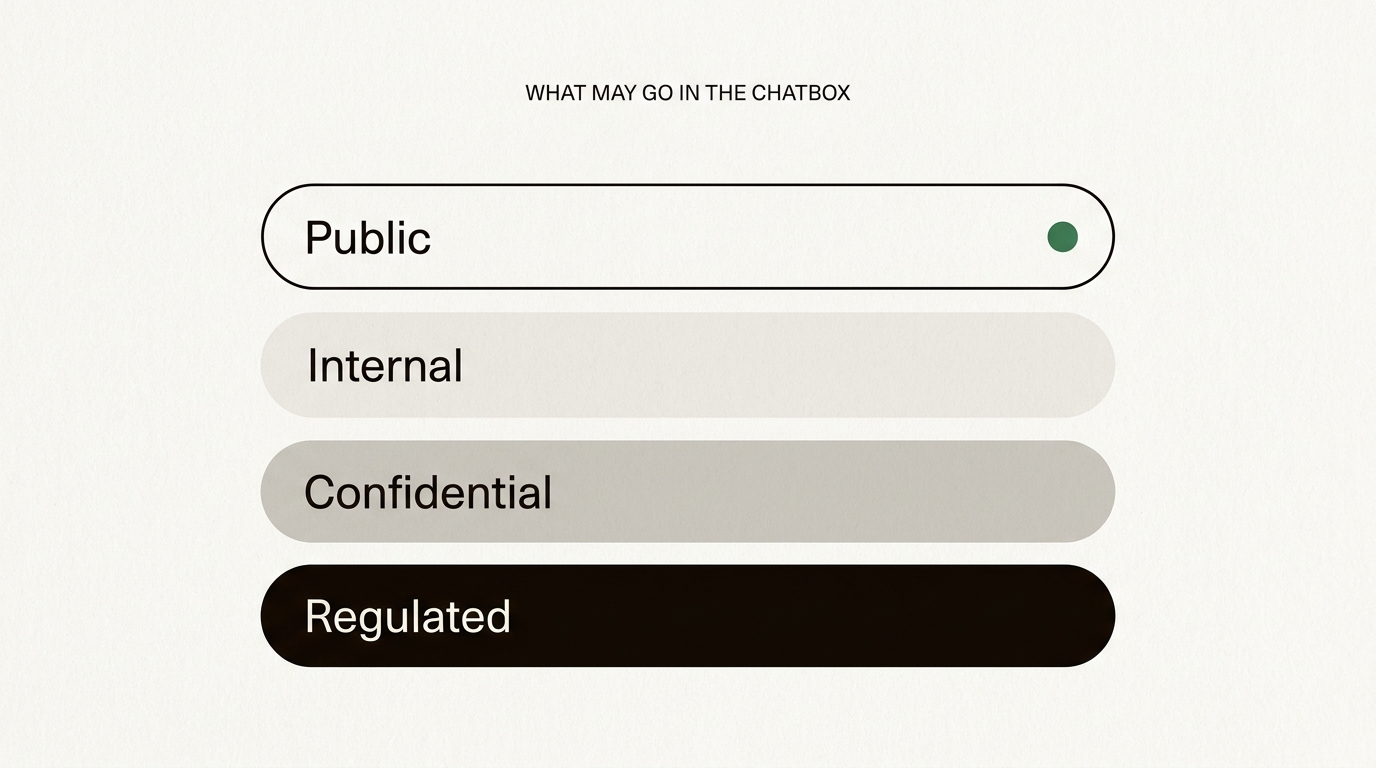
Quatre catégories, une règle chacune, et la catégorie suit la donnée, pas l’outil. Ta propre classification peut placer les limites ailleurs, ça ne pose pas de problème tant qu’elle est écrite et que quelqu’un en est responsable.
Les quatre catégories de données, et ce qui peut aller où
Une interdiction générale échoue parce que l’essentiel de ce que les gens collent est inoffensif, et que l’interdiction leur apprend à t’ignorer avant d’arriver à ce qui ne l’est pas.
Public
Tout ce qui est déjà publié : tes propres textes marketing, une FAQ publique, un communiqué de presse, une documentation ouverte. N’importe quel outil, n’importe quel compte. Il n’y a rien à divulguer.
Interne
Feuilles de route, brouillons, indicateurs internes, comptes rendus de réunion sans données personnelles de tiers. Pas de problème de RGPD, mais un vrai préjudice commercial si ça ressort. Compte professionnel, et vérifie la clause sur l’entraînement, parce qu’un modèle entraîné sur ta feuille de route est un modèle qu’on peut interroger à son sujet.
Confidentiel
Contrats clients, conditions fournisseurs, tout ce qui est couvert par une clause de confidentialité que tu as signée, plus les données personnelles ordinaires comme les noms, les e-mails et les historiques de compte. Outil validé uniquement, sous DPA, entraînement exclu. C’est dans cette catégorie que « on a juste pris la version gratuite » se transforme en discussion sur une notification de violation.
Réglementé
Données de santé, biométrie, casier judiciaire, appartenance syndicale, et tout ce qui alimente une décision automatisée sur une personne, comme le tri de candidatures. Ce n’est pas une question d’outil. Il faut d’abord une analyse documentée, et souvent la réponse honnête est que le processus ne devrait pas être automatisé du tout.
Le vrai risque, c’est la shadow AI, pas le datacenter
La plupart des données d’entreprise arrivent chez un fournisseur d’IA via le compte personnel d’un salarié un mardi après-midi, pas via une décision d’achat. Bloquer le domaine déplace simplement l’usage sur un téléphone, où tu ne peux ni le voir ni le journaliser.
La solution n’a rien de glorieux : valide un outil, rends-le facile d’accès, et écris ce qu’on peut y mettre. Les gens suivent une règle dont ils se souviennent. Ils contournent une règle qui leur coûte vingt minutes et un ticket, et c’est avec ce second type de règle qu’un contrat client finit dans un chatbot grand public.
L’avis 28/2024 du Comité européen de la protection des données sur les modèles d’IA vaut la lecture, ne serait-ce que pour le ton : sa réponse récurrente est que ces questions doivent s’apprécier au cas par cas. C’est aussi la leçon pratique. Aucun réglage ne fait disparaître le problème, il n’y a qu’une décision que quelqu’un doit assumer.
Une politique d’usage de l’IA d’une page, à copier
Assez courte pour que les gens la lisent, assez précise pour agir. Adapte les noms d’outils et le responsable, garde la structure.
- Outils validés. Nomme-les. Un seul suffit. Tout le reste passe par une demande au responsable nommé plus bas, et la demande prend en général une journée, pas un trimestre.
- Ce qui peut y entrer. Les contenus publics et internes, librement. Les contenus confidentiels uniquement dans l’outil validé. Les données réglementées jamais, sans accord écrit.
- Ce qui n’y entre jamais. Identifiants, clés API, données personnelles de candidats ou de patients, tout ce qui relève du secret professionnel, et tout ce que tu ne mettrais pas dans un e-mail envoyé à la mauvaise adresse.
- Vérifie le résultat. Les modèles se trompent avec aplomb. La personne qui a utilisé l’outil est responsable du résultat, exactement comme d’une formule de tableur qu’elle n’a pas vérifiée.
- Dis quand tu l’as utilisé. Pas de confession, juste une ligne dans le document quand l’IA a rédigé quelque chose sur quoi un collègue va s’appuyer.
- Signale les erreurs sans drame. Si un contenu confidentiel est parti là où il ne devait pas, préviens le responsable le jour même. Une erreur passée sous silence devient une notification de violation tardive, et c’est le genre qui coûte cher.
- Qui en est responsable. Un nom, une adresse e-mail, une date de révision. Une politique sans responsable finit en page de wiki que personne n’a ouverte depuis son arrivée.
Imprime-la, mets-la dans le livret d’accueil, consacre-lui quinze minutes en réunion d’équipe. C’est un gain de conformité plus grand que n’importe quel questionnaire fournisseur.
Ce qui change avec un fournisseur européen, et ce qui ne change pas
Ça raccourcit une discussion. Si l’inférence tourne sur une infrastructure située dans l’Union européenne, l’analyse des transferts cesse d’être le paragraphe le plus difficile de ta documentation, et la question « où vont ces données » obtient une réponse courte que tu peux mettre dans une politique de confidentialité. Le trajet complet d’une requête mérite d’être compris une fois, parce que c’est aussi la forme de la réponse que tu donneras à tes propres clients.
Ça ne change rien aux trois autres conditions. Il te faut toujours une base légale, un accord écrit, une réponse sur la conservation et une politique que les gens suivent. Et ça ne rend pas la chaîne du fournisseur magiquement européenne : la nôtre est publiée en entier, y compris les trois acteurs qui ont une maison mère aux États-Unis, parce qu’une liste qui les cache relève du marketing plutôt que de la transparence. Ce que vaut vraiment le mot souverain, couche par couche, est décortiqué dans l’IA souveraine européenne.
Cinq vérifications avant de valider un outil
Fais-les avant le pilote, pas après le déploiement. Elles prennent un après-midi.
- Trouve l’accord de traitement des données. S’il n’y en a pas, l’outil est exclu pour tout ce qui n’est pas public.
- Cherche « entraînement » dans les conditions. Lis chaque occurrence, y compris celles qui parlent d’« amélioration du service », souvent la même chose sous un plus joli manteau.
- Demande la liste des sous-traitants ultérieurs. Avec les régions et les entités juridiques. Puis compte les maisons mères hors de l’UE, non pas pour les disqualifier, mais pour connaître le chiffre.
- Demande ce qu’il advient d’un prompt après la réponse. Gardé combien de temps, visible par qui, et peux-tu le désactiver.
- Regarde ce que ta propre politique de confidentialité devrait dire. Si tu ne peux pas écrire ce paragraphe honnêtement, tu as ta réponse, et elle est arrivée avant le contrat plutôt qu’après.
Rien de tout ça n’exige un juriste pour un premier passage. Il faut quelqu’un avec un après-midi devant lui et l’habitude de lire la clause plutôt que la page d’accueil. Une fois qu’un outil a passé ces cinq étapes, reste à savoir quel type de fournisseur tu veux vraiment, et les quatre options réalistes sont comparées dans les fournisseurs d’IA européens comparés.
Questions fréquentes
ChatGPT est-il conforme au RGPD ?
Un outil n’est ni conforme ni non conforme en soi ; c’est le traitement que tu en fais qui l’est. Une offre entreprise avec un accord de traitement des données signé, une clause de non-entraînement et une durée de conservation définie peut être utilisée de façon conforme. Un compte personnel, utilisé pour des données clients, sans que personne ait lu les conditions, en général non.
Puis-je mettre des données clients dans un chatbot IA ?
Seulement si tu as une base légale, un accord de traitement avec le fournisseur et une clause qui précise que tes contenus ne servent pas à l’entraînement. Même dans ce cas, garde les données sensibles, comme les données de santé ou biométriques, en dehors, sauf si une analyse d’impact relative à la protection des données conclut autrement.
Un compte ChatGPT gratuit est-il autorisé au travail ?
Pour des contenus publics ou déjà publiés, en général oui. Pour tout ce qui est interne, confidentiel ou personnel, c’est le mauvais outil : les conditions grand public autorisent souvent l’entraînement sur tes contenus, ne prévoient pas d’accord de traitement et ne donnent à ton organisation aucun contrôle sur la conservation.
Qu’est-ce que la shadow AI ?
La shadow AI, ou IA fantôme, c’est quand des salariés utilisent des outils d’IA que leur organisation n’a pas validés, le plus souvent sur des comptes personnels. C’est la voie la plus courante par laquelle les données d’une entreprise arrivent chez un fournisseur d’IA, et bloquer les outils a tendance à l’augmenter plutôt qu’à la réduire. Un outil validé et une courte politique écrite marchent mieux.
Faut-il dire aux gens qu’on utilise l’IA sur leurs données ?
Dans la plupart des cas, oui. Les obligations de transparence du RGPD veulent que ta politique de confidentialité indique qu’un fournisseur d’IA traite des données personnelles pour ton compte, et l’AI Act ajoute sa propre obligation : dire aux gens quand ils interagissent avec un système d’IA plutôt qu’avec une personne.
Les avocats ou les experts-comptables peuvent-ils utiliser ChatGPT avec des dossiers clients ?
Seulement après avoir vérifié deux choses qui s’ajoutent au RGPD : les règles de secret professionnel de ton ordre ou de ton autorité de tutelle, et les clauses de confidentialité de tes lettres de mission. Les deux exigent en général un accord de traitement, une clause de non-entraînement et une décision documentée sur les catégories de dossiers qui peuvent être utilisées. C’est une question pour ton organisation professionnelle, pas pour la page marketing d’un fournisseur.
Peut-on utiliser l’IA pour trier des candidats ?
Avec prudence. Le RGPD encadre les décisions fondées exclusivement sur un traitement automatisé qui affectent quelqu’un de manière significative, et l’AI Act classe les usages liés au recrutement et à l’emploi à haut risque, ce qui entraîne des obligations supplémentaires. Se servir de l’IA pour aider un humain à lire des candidatures n’a rien à voir avec la laisser rejeter des gens, et le second cas exige une évaluation documentée avant de s’approcher de la production.