AI-API-kosten per token: wat betaal je echt?
Wat een miljoen tokens kost, waarom output duurder is dan input en wanneer een vast abonnement goedkoper uitvalt. Met echte europrijzen, zonder kleine lettertjes.
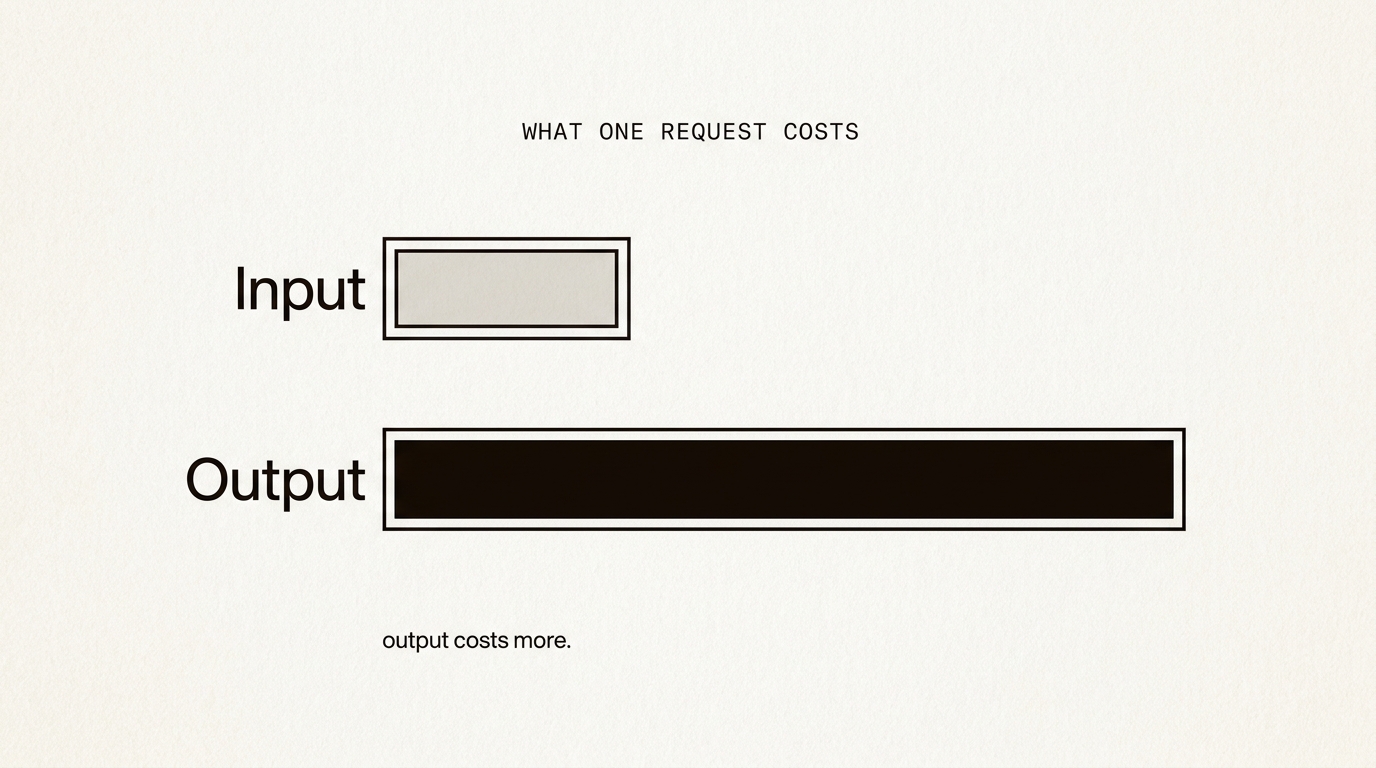
Prijzen per token betekenen dat je tekst per volume betaalt, en wel tegen twee tarieven: een voor de tokens die je verstuurt en een hoger tarief voor de tokens die het model terugschrijft. Bij Union AI loopt dat van € 0,40 per miljoen inputtokens op de goedkoopste tier tot € 12 per miljoen outputtokens op de zwaarste, exclusief btw. Aan de API hangt geen abonnement, geen maandminimum en geen factuur die je niet zelf hebt veroorzaakt.
Het lastige is dat niemand een miljoen tokens kan voelen. Dit artikel vertaalt het naar getallen die je wel kunt voelen, met dezelfde prijzen waar onze router mee afrekent.
Wat kost een miljoen tokens?
Dit is de complete prijslijst. Vier tiers, elk met twee tarieven, in euro’s, exclusief btw.
| Tier | Geschikt voor | Input per 1M | Output per 1M | Context |
|---|---|---|---|---|
| Lite | Classificatie, extractie, korte antwoorden | € 0,40 | € 1,60 | 131k tokens |
| Standaard | Het werkpaard: chat en het meeste API-verkeer | € 0,70 | € 3,50 | 262k tokens |
| Lange context | Complete dossiers, contracten, codebases | € 1,00 | € 2,00 | 1M tokens |
| Pro | Zwaar redeneerwerk, agents, complexe code | € 4,00 | € 12,00 | 1M tokens |
Twee dingen in die tabel verrassen mensen. De tier Lange context is op output goedkoper dan het werkpaard, omdat een model dat gebouwd is voor een miljoen tokens input niet per se het sterkste redeneert. En tussen de goedkoopste en de duurste tier zit een factor tien. De keuze van je tier doet dus veel meer met je rekening dan het finetunen van je prompts ooit zal doen.
De volledige tabel, met een rekentool en een vergelijking met de Amerikaanse aanbieders tegen hun lijstprijzen, staat op de prijspagina. Welk open-weight model achter elke tier zit, en onder welke licentie, lees je op de pagina over AI-transparantie.
Hoeveel tokens is een pagina, een bericht, een codebase?
Een token is een stukje tekst dat het model leest of schrijft, meestal een veelvoorkomend woord of een deel ervan. De vuistregel voor Engels is duizend tokens voor ongeveer 750 woorden. Andere talen worden minder efficiënt in tokens opgeknipt, dus dezelfde tekst in het Nederlands, Fins of Pools kost iets meer.
Een paar ijkpunten die het abstracte concreet maken:
- Een korte vraag met een alinea als antwoord: ongeveer 300 tokens erin, 200 eruit.
- Een middelgroot bericht, met wat context en een uitgewerkt antwoord: zo’n 900 erin en 500 eruit. Dat is de aanname achter elk bedrag op onze prijspagina.
- Een contract van 40 pagina’s: ergens rond de 20.000 inputtokens. Er een samenvatting van maken op de Standaard-tier kost een fractie van een cent.
- Een middelgrote codebase, zeg 5.000 regels: past ruim in het venster van 262.000 tokens van de Standaard-tier, en komt lang niet in de buurt van het miljoen van de tier Lange context.
Stuur het middelgrote bericht door de Standaard-tier en je betaalt € 2,38 voor duizend stuks. Dat getal is het onthouden waard, want het zet de hele vraag in een ander licht: voor de meeste teams is het model niet het dure deel van het product.
Waarom is output duurder dan input?
Omdat schrijven trager werk is dan lezen. Inputtokens gaan in één parallelle stap door het model, dus een lange prompt kost ongeveer wat zijn lengte doet vermoeden en niet meer. Outputtokens komen er een voor een uit, elk afhankelijk van het vorige, en de hardware is de hele reeks bezet. Het hogere outputtarief is die seriële tijd.
Daar volgt een gewoonte uit die de moeite waard is: begrens je output, niet je input. Een heel document in de prompt plakken is meestal goedkoop. Om een antwoord van duizend woorden vragen terwijl honderd woorden volstaan, is wat je echt op de rekening terugziet. max_tokens instellen is de effectiefste kostenbeheersing in de API, en het is één regel.
Chatabonnement
€ 13,00
€ 13 per maand, 2.000 berichten inbegrepen op deze tier, de rest van je tegoed.
API, per token
€ 4,76
€ 0,70 in en € 3,50 uit per miljoen tokens, geen vaste kosten.
Hier is de API goedkoper, met € 8,24 per maand.
Dit middelgrote bericht is 900 tokens in en 500 uit, dezelfde aannames als op de prijspagina. Beide bedragen zijn exclusief btw, en de vergelijking gaat alleen over geld: met het abonnement krijg je ook een interface, bijlagen en gedeelde gesprekken, wat kale tokens je niet geven.
Is betalen per gebruik goedkoper dan een abonnement?
Bij een laag volume bijna altijd. Een paar honderd berichten per maand via de API kost op de Standaard-tier ruim minder dan een euro, terwijl elk abonnement hetzelfde vaste bedrag rekent, of je het gebruikt of niet. Onder de duizend berichten per maand is het voor prijzen per token niet eens een eerlijke strijd.
Het beeld draait om in drie gevallen, die je met de vergelijking hierboven zelf kunt opzoeken:
- Lange berichten. Een prompt van vierduizend tokens met een lang antwoord kost een veelvoud van een middelgroot bericht, en dan oogt het vaste bedrag niet meer zo gek.
- De dure tier. Een Pro-antwoord kost van je tegoed ongeveer vier keer zoveel als een Standaard-antwoord, en telt als vijf berichten van de maandelijkse bundel van het chatabonnement.
- Je wilt het product, niet de leiding. Ons chatabonnement kost € 13 per maand voor een interface, bijlagen, lange documenten en gedeelde gesprekken, of € 11 per maand als je een jaar vooruit betaalt. Dat zelf bouwen bovenop de API kost je in de eerste middag al meer dan € 13 aan eigen tijd.
Een abonnement is een gok op hoe duur je gemiddelde bericht uitvalt. Prijzen per token is weigeren om te gokken.
Geen van beide modellen is eerlijker dan het andere. Wat een prijs eerlijk maakt, is of je hem kunt voorspellen voordat je je vastlegt. Daarom noemt onze rekentool zijn aannames in plaats van een vriendelijk ogend maandbedrag te geven.
Wat prijzen per token verbergen
Vier dingen waardoor echte rekeningen afwijken van het rekenwerk. Geen ervan is een truc, en toch trappen mensen er allemaal in.
De gespreksgeschiedenis gaat bij elke beurt opnieuw mee
Een API-call is stateless. Beurt tien van een gesprek stuurt beurt een tot en met negen mee, dus de inputtokens groeien met de lengte van de thread. Een lange chat kan meer uitgeven aan het herlezen van zijn eigen geschiedenis dan aan iets nieuws. Oude beurten inkorten of samenvatten is geen voorbarige optimalisatie, het is de belangrijkste knop waar je aan kunt draaien.
Retries en agents vermenigvuldigen je requests
Eén actie van een gebruiker in een agent-loop kan twintig modelcalls zijn. Vermenigvuldig de kosten per request met de loop, niet met de gebruiker. Kijk daarna wat er gebeurt als de loop niet stopt; daar zijn de plafonds in de volgende sectie voor.
De tarieven in de etalage zijn niet de hele prijslijst
Aanbieders publiceren kortingen voor gecachte input, batchjobs en toegezegde afname. Die zijn echt, en ze betekenen dat een vergelijking alleen klopt als beide kanten tegen het standaardtarief staan. Onze vergelijkingstabel gebruikt daarom aan beide kanten lijstprijzen, met de wisselkoers en de datum waarop die is afgelezen eronder. Dezelfde getallen worden per aanbieder doorgerekend in Europese AI-aanbieders vergeleken.
Mislukt werk kost ook geld, tenzij iemand anders beslist
Als een model iets onbruikbaars teruggeeft, hebben de meeste meters de tokens al geteld. Wij kiezen de andere kant: een request dat geen bruikbaar antwoord opleverde, gaat niet van je saldo af, en een omgeleid request dat op een zwakker model belandt, rekenen we af tegen het laagste van de twee tarieven. In de documentatie staan de headers die laten zien welke van de twee er gebeurde.
Betaal ik btw over vooraf betaald AI-tegoed?
Dat hangt af van wie je bent en waar. Ben je een bedrijf in een ander EU-land met een geldig btw-nummer, dan wordt de btw verlegd: wij rekenen geen btw en jij draagt die zelf af. De uitleg van de Europese Commissie over btw op grensoverschrijdende diensten zegt het zonder omwegen: klanten betalen btw over de ontvangen diensten tegen het tarief in hun eigen land, volgens de verleggingsregeling.
Heb je geen geldig btw-nummer, of koop je als consument, dan geldt de btw tegen het tarief van waar jij zit. Elke prijs op deze site is exclusief btw, en op je factuur staat welke van de twee behandelingen van toepassing was.
Hoe voorkom je dat een tokenrekening uit de hand loopt?
Het probleem is nooit de prijs per miljoen. Het is een loop, een uitgelekte key of een job die het hele weekend doorliep. Vijf verdedigingslinies, in de volgorde waarin je ze het best instelt:
- Stel een plafond per key in, in euro’s, per dag en per maand. Een key zonder plafond is een blanco cheque.
- Zet
max_tokensop elke call. Zie het outputtarief hierboven. - Lees
X-EU-Cost-EURop de response. Elk request vertelt je wat het van je saldo afhaalde, zodat je eigen logs de kostenvraag beantwoorden zonder dashboard. - Houd je saldo klein. Vooraf betaald tegoed heeft een harde bodem bij nul, en dat is een feature. Een opwaardering van € 10 kan geen verrassing van € 4.000 worden.
- Laat de anomaliecheck zijn werk doen. Zien we binnen een uur meer dan tien keer je weekgemiddelde, dan pauzeren we de key en mailen we je. Nieuwe accounts zitten de eerste 48 uur op maximaal € 25 per dag, wat het saldo ook is.
Die laatste levert af en toe een vals alarm op. Wij vinden een onderbroken batchjob een betere uitkomst dan een lege portemonnee, en je kunt de limiet zelf opheffen zodra je weet dat het verkeer van jou is.
Wat kost het om te beginnen?
Tien API-requests zijn gratis, je laadt minimaal € 10 op en tegoed blijft 24 maanden geldig. Voor het uitproberen van de chat is geen kaart nodig: je krijgt 5 gratis berichten voordat er iets van je gevraagd wordt.
Een bestaande integratie overzetten om die getallen op je eigen verkeer te zien, is een key, een base URL en een tiernaam. Daarover gaat overstappen in drie regels.
Dat is het hele commerciële verhaal. Wil je de andere helft, waar die tokens worden verwerkt en wie ze onderweg kan lezen, dan loopt het zusterartikel over dataresidentie voor AI in de EU hetzelfde request stap voor stap door, en Europese soevereine AI laat zien wat het woord soeverein nog waard is als je het uit elkaar haalt.
Veelgestelde vragen
Wat kost een miljoen tokens?
Dat hangt af van het model en van de vraag of de tokens erin gaan of eruit komen. Bij Union AI kost een miljoen inputtokens tussen 0,40 en 4 euro, afhankelijk van de tier, en een miljoen outputtokens tussen 1,60 en 12 euro, exclusief btw. Output is altijd de duurste helft, bij elke aanbieder.
Wat is een token in een AI-API?
Een token is een stukje tekst dat het model leest of schrijft, meestal een veelvoorkomend woord of een deel ervan. Als vuistregel voor Engels staan duizend tokens voor ongeveer 750 woorden, dus een A4’tje lopende tekst komt uit op zo’n 500 tokens. Bij de afrekening worden de tokens die je verstuurt en de tokens die het model genereert apart geteld.
Waarom is output duurder dan input?
Omdat tekst genereren trager werk is dan tekst lezen. Inputtokens kunnen in één parallelle stap worden verwerkt, terwijl outputtokens een voor een worden gemaakt, en elk token op het vorige wacht. Dat verschil in rekentijd is waar het hogere outputtarief voor betaalt.
Is betalen per gebruik goedkoper dan een AI-abonnement?
Bij een laag volume bijna altijd. Een paar honderd berichten per maand via een API kost vaak minder dan een euro, terwijl een abonnement een vast bedrag rekent, of je het nu gebruikt of niet. Een abonnement wint als je berichten lang zijn, als je het dure model gebruikt of als je een kant-en-klare interface wilt in plaats van een API.
Hoeveel tokens is een document van 40 pagina’s?
Ruwweg 20.000 inputtokens voor 40 pagina’s gewone lopende tekst, uitgaande van ongeveer 750 woorden per duizend tokens. Op een tier in het middensegment kost het lezen daarvan een fractie van een cent. Daarom is lange input zelden wat een AI-rekening groot maakt.
Waarom groeide mijn AI-rekening harder dan mijn gebruik?
Bijna altijd omdat de gespreksgeschiedenis bij elke beurt opnieuw wordt meegestuurd. Een API-call is stateless, dus beurt tien sleept beurt een tot en met negen mee, en de inputtokens groeien met de lengte van de thread in plaats van met het aantal gebruikers. Agent-loops doen hetzelfde: één actie van een gebruiker wordt twintig requests op de rekening.
Hoe schat ik de kosten van een LLM in voordat ik ga bouwen?
Neem één realistisch request, tel de input- en outputtokens apart en vermenigvuldig met je verwachte volume tegen de tarieven per miljoen van de aanbieder. Verdubbel daarna het outputgetal als veiligheidsmarge en tel alles op wat je ontwerp opnieuw meestuurt, zoals chatgeschiedenis of opgehaalde documenten. Die schatting zit meestal in de juiste orde van grootte, en meer heb je voor een bouwbeslissing niet nodig.