Soevereine AI in Europa: wat het echt betekent
Soevereine AI is vier aparte vragen: het gebouw, de beheerder, de gewichten en de waarden. Wat Europa vandaag kan beantwoorden, en wat jij dit kwartaal kunt doen.
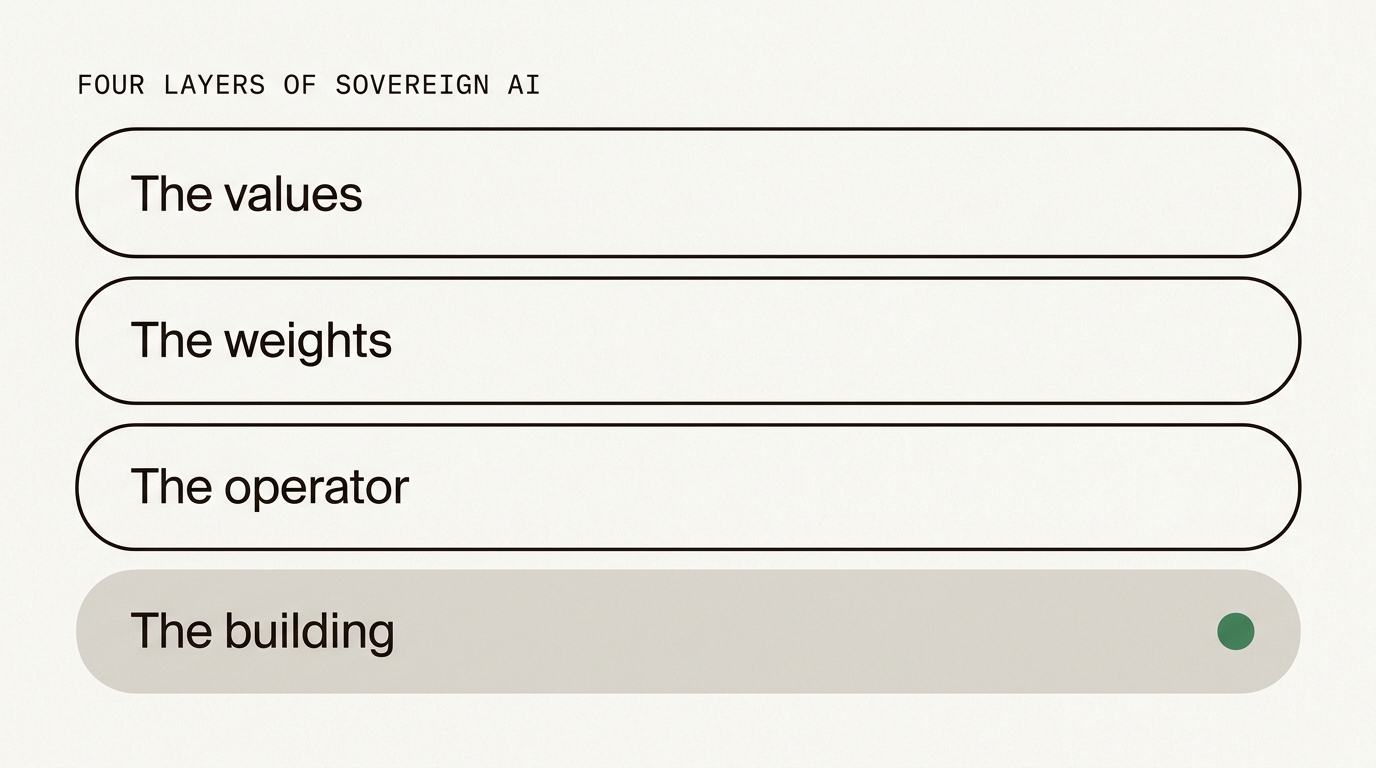
Soevereine AI is niet één eigenschap. Het zijn vier vragen die op elkaar gestapeld zijn: waar de hardware staat, welke staat het bedrijf kan dwingen dat die hardware beheert, wie het model heeft getraind, en welke aannames het model met zich meedraagt. Europa beantwoordt de eerste goed, de tweede met voorbehoud, en de derde en vierde maar deels. Wie je alle vier in één woord verkoopt, verkoopt je een ambitie.
Dat is het waard om eerst helder te zeggen, voordat er een product ter sprake komt, ook het onze. De nuttige versie van dit debat is niet “Europees of Amerikaans”. Het is: welke laag van de stack heeft deze specifieke toepassing echt nodig, en wat kost het om die laag te verplaatsen?
Wat betekent soevereine AI eigenlijk?
Het woord komt uit het debat over rekenkracht, waar het een precieze betekenis had: een staat moet kritieke systemen kunnen draaien zonder toestemming van een andere staat. Toegepast op AI werd het opgerekt tot alles van de postcode van een datacenter tot de politieke voorkeur van een chatbot, en onderweg verloor het het grootste deel van zijn bruikbaarheid.
Haal het weer uit elkaar en elk deel wordt controleerbaar.
Soevereiniteit is geen badge op een landingspagina. Het zijn vier vragen met vier verschillende antwoorden, en eerlijke providers vertellen je welke ze beantwoorden.
Het gebouw is geografie: in welk land de hardware staat. De beheerder is jurisdictie: welk rechtssysteem het bedrijf bindt dat die hardware draait. De gewichten zijn herkomst: wie het model heeft getraind, op welke data, onder welke licentie. De waarden zijn gedrag: wat het model zegt, weigert, en stilletjes verkeerd heeft over jouw deel van de wereld.
Wie kan elke laag vandaag in Europa leveren?
| Laag | De vraag | Europa vandaag |
|---|---|---|
| Het gebouw | Waar staat de hardware? | Opgelost. Europese capaciteit is echt en te boeken |
| De beheerder | Welke staat kan de beheerder dwingen? | Beschikbaar voor inferentie, lastiger voor hosting, databases en betalingen |
| De gewichten | Wie heeft het model getraind? | Dun en het wordt beter, met een tekort aan rekenkracht dat nu wordt ingelopen |
| De waarden | Wat zegt en weigert het model? | Deels, en vooral via documentatie in plaats van training |
De lagen worden moeilijker naarmate je hoger komt, en de prijs van elke laag stijgt mee. Europese rekenkracht huren is een inkoopbeslissing. Een concurrerend frontiermodel trainen in Europa is een industrieel project van meerdere jaren, en precies daarvoor is de huidige golf aan EU-financiering bedoeld.
Waar staat de hardware fysiek?
- Wat Europa vandaag kan leveren
- Opgelost. Europese datacentercapaciteit is echt, te boeken en groeit.
- Wat Union AI doet
- Alle AI-inferentie draait op infrastructuur binnen de Europese Unie.
Eén groene stip van de vier. Een provider die vandaag alle vier claimt, beschrijft een ambitie, geen stack die je kunt kopen.
Zijn er Europese LLM’s die de moeite waard zijn?
Ja, en het eerlijke beeld is dat van een jong vakgebied, niet van een af product. Het valt uiteen in twee soorten inspanningen.
De eerste is commercieel. Europese labs brengen open-weight modellen uit die je kunt downloaden en zelf draaien, en hun kleinere modellen kunnen echt meekomen voor dagelijks werk. Dit is het deel van de Europese stack dat vandaag al in productie werkt.
De tweede is publiek. OpenEuroLLM is een consortium van Europese universiteiten, HPC-centra en bedrijven, gefinancierd via het programma Digitaal Europa, dat open basismodellen bouwt voor de officiële talen van de EU en de data, code en evaluaties naast de gewichten publiceert. Dat laatste weegt zwaarder dan de modelscores: een model waarvan de trainingsdata en evaluaties openbaar zijn, is een model dat je kunt controleren, en aan de frontier is vandaag bijna niets controleerbaar.
Onder allebei ligt rekenkracht. Het programma voor AI-gigafabrieken van de Commissie mobiliseert € 20 miljard via de InvestAI-faciliteit voor grootschalige trainingscapaciteit in Europa. De informele oproep tot belangstelling leverde 77 voorstellen op uit 16 lidstaten voor 60 locaties, en de bouw van de eerste locatie wordt vanaf 2027 verwacht. Of dat het gat in capaciteit dicht, is een open vraag. Het betekent wel dat het antwoord in 2029 niet het antwoord van vandaag is, en dat is een reden om je stack overdraagbaar te houden, niet om te wachten.
Kan een model worden getraind op Europese waarden?
Deels, en de uitdrukking verdient meer kritische blik dan ze meestal krijgt. “Getraind op Europese waarden” doet drie verschillende dingen tegelijk, en maar twee daarvan zijn controleerbaar.
Taal is een waarde, en die is meetbaar
Een model dat Nederlands, Fins, Grieks en Portugees net zo goed beheerst als Engels, is voor Europese gebruikers een ander product dan een model dat die talen als bijzaak behandelt. Taaldekking test je in een middag: draai je eigen prompts, in je eigen talen, en vergelijk. Dit is de nuttigste test in het hele soevereiniteitsdebat, en bijna niemand doet hem voordat hij koopt.
Weigergedrag verraadt de training
Sommige open-weight modellen zijn getraind onder rechtssystemen met hun eigen gevoeligheden, en ontwijken feitelijke vragen over politiek of geschiedenis die een Europese gebruiker volkomen normaal vindt. Wij zien dat als een gebrek, niet als een veiligheidsfunctie. Als ons systeem zo’n weigering in de eerste zin van een antwoord herkent, breekt het het antwoord af en stelt het de vraag opnieuw aan een model zonder die blinde vlek, maximaal één keer per request, en het vertelt je dat dit is gebeurd in de header X-EU-Routed. Wat we niet doen, is echte veiligheidsweigeringen omzeilen: die blijven geweigerd, want doorsturen tot een model toegeeft is een geautomatiseerde jailbreak.
De rest is documentatie, geen training
De rest van wat mensen met waarden bedoelen, dat een model eerlijk, evenwichtig en gepast is, kun je niet controleren via een marketingpagina. Wat je wel kunt controleren, is of de provider het model, de licentie, de systeemprompt en het gemeten weigerpercentage publiceert. Wij publiceren alle vier op onze pagina over AI-transparantie, ook de delen waar we minder goed uit de verf komen.
Heb je voor veilige data een Europees model nodig?
Nee, en wie die twee door elkaar haalt, betaalt daar echt geld voor. Waar een model is getraind en waar je prompt wordt verwerkt, zijn twee losse feiten.
Gewichten zijn een bestand. Download een open-weight model, draai het op Europese hardware, en je prompt gaat naar die hardware en komt terug, wie het model ook heeft getraind. Wat met de gewichten meereist, is gedrag, geen datastroom. Daarom kan onze stack eerlijk zijn over het draaien van grotendeels niet-Europese modellen terwijl elk request toch binnen de Europese Unie wordt verwerkt, en daarom telt het pad van een request voor gegevensbescherming zwaarder dan het herkomstverhaal van het model.
De vier vragen over dataveiligheid die je elke provider moet stellen, Europees of niet: waar wordt de inferentie verwerkt, hoe lang worden prompts bewaard, worden ze gebruikt voor training, en welke partijen in de keten hebben een moederbedrijf buiten de EU. Onze antwoorden staan op de pagina met subverwerkers, ook de ongemakkelijke.
Wat je dit kwartaal echt kunt doen
Soevereiniteit als inkoopbeslissing mislukt, want niets op de markt haalt alle vier de lagen. Soevereiniteit als reeks kleine stappen werkt wel. Grofweg op volgorde van opbrengst:
- Classificeer je toepassingen voordat je naar leveranciers kijkt. De meeste teams hebben één deel echt gevoelig verkeer en een grote meerderheid die gewoon is. Die verhouding kennen verandert welke afwegingen het waard zijn om voor te betalen.
- Verplaats het gevoelige deel eerst. Klantcontracten, HR-dossiers, patiëntnotities, code die nog niet uit is. Laat het samenvatten van openbare webpagina’s waar het is.
- Vraag de lijst met subverwerkers en de trainingsclausule schriftelijk op. Geen salesgesprek. Een lijst met regio’s en juridische entiteiten, plus een zoektocht naar het woord “train” in de voorwaarden.
- Houd de interface saai. Een OpenAI-compatibele API is meer waard dan welke soevereiniteitsclaim ook, omdat overstappen daardoor goedkoop is. Overdraagbaarheid is de enige vorm van onderhandelingsmacht die overeind blijft als een leverancier van gedachten verandert. De onze staat in de API-referentie, en wat een overstap echt inhoudt, lees je in overstappen in drie regels.
- Log bewijs per request. Een header die de tier, de aantallen tokens en de kosten noemt, maakt van een bewering een audittrail.
- Doe de test over zes maanden opnieuw. Het Europese modellandschap beweegt sneller dan welke inkoopcyclus ook. Aannames van vorig jaar zijn verouderd.
Niets daarvan vraagt om een herbouw, en alles blijft overeind, welke kant de markt ook op gaat.
Waar wij passen, en waar niet
Union AI is een Europese dienst die open-weight modellen draait, met alle AI-inferentie op infrastructuur binnen de Europese Unie, vooraf betaald in euro’s en geprijsd per token. We dekken de onderste laag volledig, het grootste deel van de beheerderslaag, en we zijn open over de twee lagen daarboven.
Onze modellen zijn open weight onder Apache 2.0 en MIT, en de meeste zijn niet in Europa getraind. Het enige in Europa getrainde model in onze stack is vandaag het Mistral-model waarop we op de goedkoopste tier terugvallen als het primaire model faalt. Die zin schrijven we liever op dan dat we het woord soeverein het werk laten doen.
Hoe dat zich verhoudt tot de drie andere manieren om AI in Europa in te kopen, inclusief de rijen waarop we verliezen, lees je in Europese AI-providers vergeleken.
De pitch is dus bewust smal. Wil je dat je prompts in Europa worden verwerkt, door een Europese provider, op modellen waarvan het gedrag is gedocumenteerd en de rekening voorspelbaar is, dan bestaat dat vandaag en kun je er deze week mee beginnen. Wil je een Europees frontiermodel dat is getraind op Europese data, dan wordt dat gebouwd, met publiek geld en een gepubliceerde tijdlijn, en noch wij noch iemand anders kan het je al verkopen.
Veelgestelde vragen
Wat is soevereine AI?
Soevereine AI is het idee dat een land of unie AI-systemen kan draaien die het zelf in de hand heeft, op eigen voorwaarden. In de praktijk valt het uiteen in vier vragen: waar de hardware staat, welke staat de beheerder kan dwingen, wie het model heeft getraind, en wiens waarden het model weerspiegelt. De meeste leveranciers beantwoorden er één van de vier en gebruiken het woord voor alle vier.
Heb ik een Europees LLM nodig om aan de AI-verordening te voldoen?
Nee. De AI-verordening (AI Act) regelt hoe AI-systemen worden gebouwd, gedocumenteerd en aan mensen gepresenteerd, niet waar het model is getraind. Een Amerikaans of Chinees open-weight model kun je in overeenstemming met de regels gebruiken, en een Europees model kun je in strijd ermee gebruiken. Compliance gaat over je verplichtingen als aanbieder of gebruiksverantwoordelijke, niet over het paspoort van de gewichten.
Zijn open-weight modellen hetzelfde als open source?
Nee, en het verschil doet ertoe. Open weight betekent dat je het model kunt downloaden en zelf draaien, meestal onder een licentie als Apache 2.0 of MIT. Open source in de volle betekenis zou ook gepubliceerde trainingsdata en reproduceerbare trainingscode betekenen, en die leveren de meeste open-weight releases niet.
Kan ik een Chinees open-weight model gebruiken en mijn data toch in Europa houden?
Ja. Gewichten zijn een bestand. Download je een model en draai je het op Europese infrastructuur, dan gaan je prompts naar die hardware en nergens anders heen, wie het model ook heeft getraind. Wat met de gewichten meereist, is niet je data maar het gedrag van het model, inclusief onderwerpen die het heeft geleerd te vermijden.
Is mijn data veilig als een model in Europa draait?
Het neemt één soort risico weg en laat andere staan. Het betekent dat je prompts op Europese infrastructuur worden verwerkt in plaats van naar het buitenland te gaan, maar het zegt niets over bewaartermijnen, training op je input, toegangsbeheer, of de vraag of de beheerder een moederbedrijf buiten de EU heeft. Vraag naar alle vier apart.
Wat betekent het als een model is getraind op Europese waarden?
In de praktijk betekent het drie dingen die je kunt controleren: dat het goed overweg kan met Europese talen, dat het feitelijke vragen over politiek en geschiedenis beantwoordt in plaats van ze te ontwijken, en dat de trainingsdata en het weigergedrag zijn gedocumenteerd. Het is geen slogan die je kunt verifiëren, dus zie het als een reeks tests die je zelf draait en niet als een label dat je vertrouwt.
Welke EU-projecten trainen Europese taalmodellen?
OpenEuroLLM is het zichtbaarst: een consortium van Europese universiteiten, HPC-centra en bedrijven, gefinancierd via het programma Digitaal Europa, dat open modellen bouwt voor de officiële talen van de EU en de data en evaluaties naast de gewichten publiceert. Daaronder mobiliseert het programma voor AI-gigafabrieken van de Commissie 20 miljard euro via de InvestAI-faciliteit, voor de trainingscapaciteit die die modellen nodig hebben.