Voldoet ChatGPT aan de AVG voor bedrijfsdata?
Ja, onder voorwaarden. Welk account, welke clausules en welke data de doorslag geven, plus een AI-beleid van één pagina waar je team zich echt aan houdt.
Ja, onder voorwaarden, en die voorwaarden zijn het hele verhaal. De AVG (GDPR) certificeert geen tools, ze regelt verwerking: dezelfde chatbot kan door het ene team rechtmatig worden gebruikt en door het team ernaast onrechtmatig. Het verschil zit in welk account ze hebben gekocht, of er een verwerkersovereenkomst is, of invoer wordt gebruikt voor training, en welke data er echt in wordt geplakt.
Dat laatste punt missen de meeste beleidsstukken. Niemand in je bedrijf beslist “gaan we AI gebruiken”; mensen beslissen veertig keer per dag of deze ene alinea in het invoerveld mag. Een beleid dat die vraag op één pagina beantwoordt, wint het van een inkooptraject dat niets beantwoordt.
Het korte antwoord, en de vier voorwaarden
Elke AI-assistent kan onderdeel zijn van een AVG-conforme verwerking als aan vier dingen tegelijk is voldaan.
- Een grondslag voor de onderliggende verwerking, die je toch al nodig had. De AI-tool schept er geen en neemt er ook geen weg.
- Een verwerkersovereenkomst met de aanbieder volgens artikel 28, want persoonsgegevens in je prompts maken de aanbieder tot verwerker.
- Geen training op je invoer, op papier, in de voorwaarden die je echt hebt getekend en niet in een blogpost van de leverancier.
- Een antwoord over bewaren: hoe lang prompts worden bewaard, door wie, en of je het kunt uitzetten.
Mis je er één, dan heb je niet in theorie een complianceprobleem; dan heb je een alinea die je niet in je eigen privacyverklaring kunt schrijven. Meestal is dat het moment waarop teams het gat ontdekken.
Consumentenaccount of zakelijk account: het verschil dat telt
Aanbieders verkopen hetzelfde model twee keer, onder heel andere voorwaarden. Het model is niet wat verandert.
| Consumentenabonnement | Zakelijke of API-versie | |
|---|---|---|
| Verwerkersovereenkomst | Meestal geen | Standaard, vaak zelf af te sluiten |
| Training op je invoer | Vaak standaard aan, soms uit te zetten | Normaal contractueel uitgesloten |
| Controle over bewaren | Geen | Vastgelegd, soms instelbaar |
| Wie is verantwoordelijk | De medewerker die zich aanmeldde | Je organisatie |
| Geschikt voor | Openbaar materiaal, persoonlijk gebruik | Interne data en klantgegevens, onder de voorwaarden hierboven |
Lees je eigen contract in plaats van deze tabel, want de voorwaarden schuiven. De controle kost tien minuten: open de voorwaarden, zoek op “train”, zoek op “retention” en kijk of de woorden “data processing agreement” erin staan. Levert zoeken op die drie niets op, dan zit je op een consumentenproduct, wat er ook op de factuur staat.
Compliance is geen eigenschap van de tool. Het is een eigenschap van de afspraak tussen jou, de aanbieder en de data die je verstuurt.
Heb ik een verwerkersovereenkomst nodig om AI op het werk te gebruiken?
Als de persoonsgegevens van anderen in je prompts belanden, ja. Jij bent de verwerkingsverantwoordelijke, de AI-aanbieder is de verwerker, en artikel 28 eist dat de overeenkomst op schrift staat. Dat geldt voor een samenvattingstool, voor een tool die antwoorden op supporttickets opstelt en voor een codeerassistent die toevallig een klantnaam in een stacktrace ziet.
De onze staat samengevat op de pagina over de verwerkersovereenkomst en de tekst om te ondertekenen is één e-mail verwijderd, geen salesgesprek. Dat is een behoorlijke norm om elke aanbieder aan te houden: verschijnen de voorwaarden pas als je in een inkooptraject zit, dan zegt dat iets over hoe vaak ze veranderen.
Twee dingen die mensen van een verwerkersovereenkomst verwachten maar die hij niet doet. Hij geeft je geen grondslag. En hij maakt bijzondere persoonsgegevens niet veilig om te plakken; gezondheids-, biometrische en vergelijkbare gegevens vragen om een eigen beoordeling, en de richtlijnen van de Franse toezichthouder over AI en de AVG zijn een redelijk vertrekpunt voor wat die beoordeling moet dekken.
Openbaar
Elke tool, ook een gratis account.
Het is al openbaar. Wat je plakt, kan niets lekken wat de wereld niet toch al kan lezen.
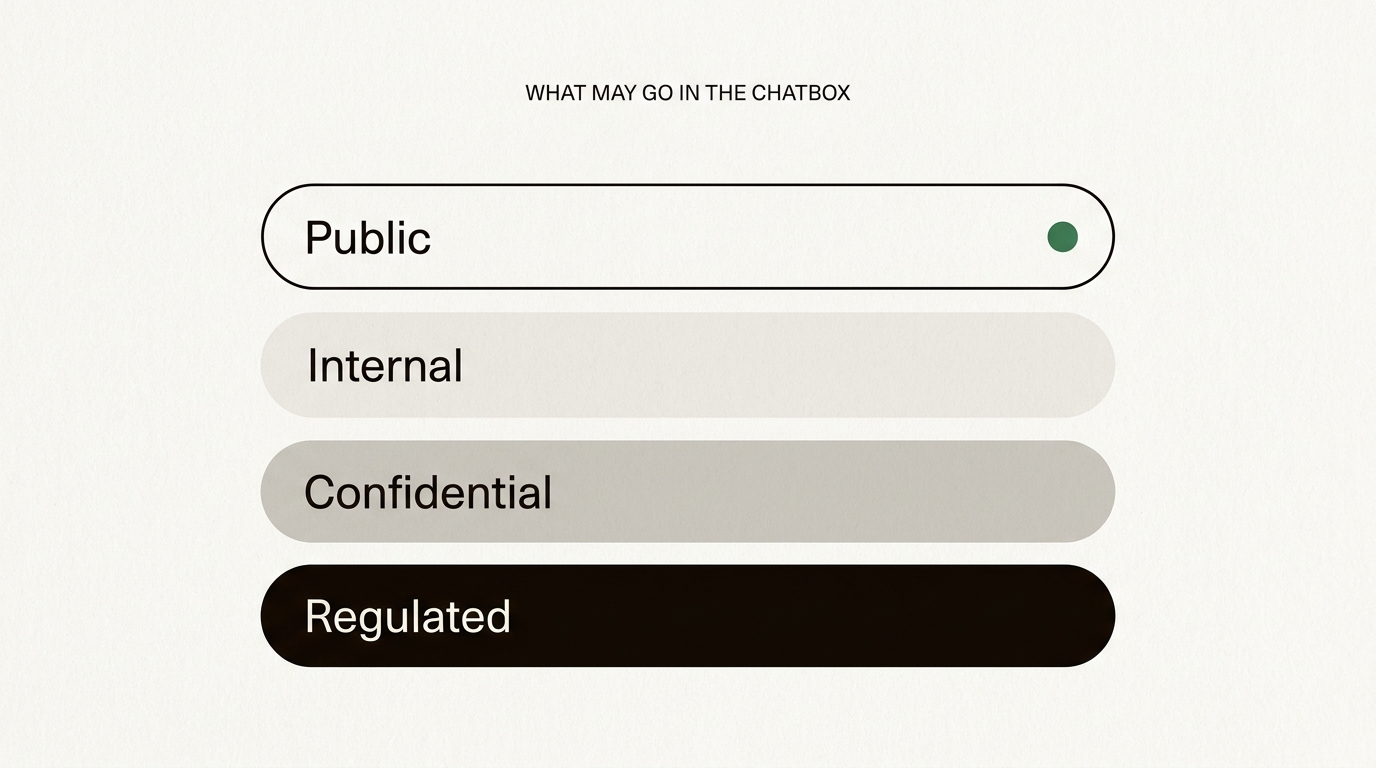
Vier klassen, elk één regel, en de klasse reist mee met de data, niet met de tool. Je eigen indeling legt de grenzen misschien ergens anders, en dat is prima zolang het op papier staat en iemand er eigenaar van is.
De vier dataklassen, en wat waar in mag
Een algemeen verbod faalt omdat het meeste wat mensen plakken onschuldig is, en het verbod leert ze je te negeren voordat ze bij het deel komen dat dat niet is.
Openbaar
Alles wat al gepubliceerd is: je eigen marketingteksten, een openbare FAQ, een persbericht, open documentatie. Elke tool, elk account. Er valt niets te lekken.
Intern
Roadmaps, concepten, interne cijfers, notulen zonder persoonsgegevens van derden. Geen probleem voor de AVG, wel echte commerciële schade als het uitlekt. Zakelijk account, en controleer de trainingsclausule, want een model dat op je roadmap is getraind, is een model dat je ernaar kunt vragen.
Vertrouwelijk
Klantcontracten, leveranciersvoorwaarden, alles waarvoor je een geheimhoudingsclausule tekende, plus gewone persoonsgegevens zoals namen, e-mailadressen en accountgeschiedenissen. Alleen in een goedgekeurde tool, onder een verwerkersovereenkomst, met training uitgesloten. In deze klasse verandert “we gebruikten gewoon de gratis versie” in een gesprek over een datalekmelding.
Gereguleerd
Gezondheidsgegevens, biometrie, strafrechtelijke gegevens, vakbondslidmaatschap, en alles wat een geautomatiseerd besluit over een persoon voedt, zoals het schiften van sollicitanten. Geen vraag over tools. Hier is eerst een gedocumenteerde beoordeling nodig, en vaak is het eerlijke antwoord dat het proces helemaal niet geautomatiseerd moet worden.
Schaduw-AI is het echte risico, niet het datacenter
De meeste bedrijfsdata komt bij een AI-aanbieder terecht via het persoonlijke account van een medewerker op een dinsdagmiddag, niet via een inkoopbesluit. Blokkeer je het domein, dan verhuist dat naar een telefoon, waar je het niet kunt zien en niet kunt loggen.
De oplossing is weinig spectaculair: keur één tool goed, maak hem makkelijk bereikbaar en schrijf op wat erin mag. Mensen volgen een regel die ze kunnen onthouden. Ze lopen om een regel heen die ze twintig minuten en een ticket kost, en die tweede soort regel is hoe een klantcontract in een consumentenchatbot belandt.
Advies 28/2024 over AI-modellen van het Europees Comité voor gegevensbescherming (EDPB) is hier het lezen waard, al is het maar om de toon: het antwoord dat steeds terugkomt, is dat deze vragen per geval beoordeeld moeten worden. Dat is ook de praktische les. Er is geen instelling die dit laat verdwijnen, alleen een besluit waar iemand eigenaar van moet zijn.
Een AI-beleid van één pagina om over te nemen
Kort genoeg dat mensen het lezen, concreet genoeg om naar te handelen. Pas de namen van de tools en de eigenaar aan, houd de vorm.
- Goedgekeurde tools. Noem ze. Eén is genoeg. Voor al het andere doe je een verzoek bij de eigenaar hieronder, en dat verzoek duurt meestal een dag, geen kwartaal.
- Wat erin mag. Openbaar en intern materiaal, vrij. Vertrouwelijk materiaal alleen in de goedgekeurde tool. Gereguleerde data nooit, zonder schriftelijke goedkeuring.
- Wat er nooit in mag. Inloggegevens, API-keys, persoonsgegevens van sollicitanten of patiënten, alles wat onder een beroepsgeheim valt, en alles wat je niet in een e-mail naar het verkeerde adres zou zetten.
- Controleer de output. Modellen hebben vol overtuiging ongelijk. Wie de tool gebruikte, is eigenaar van het resultaat, precies zoals je eigenaar bent van een spreadsheetformule die je niet hebt gecontroleerd.
- Zeg wanneer je het gebruikte. Geen biecht, gewoon een regel in het document als AI iets opstelde waar een collega op gaat vertrouwen.
- Meld fouten zonder drama. Is vertrouwelijk materiaal ergens beland waar het niet hoort, vertel het de eigenaar dezelfde dag. Een stille fout wordt een late datalekmelding, en dat is de dure soort.
- Wie is de eigenaar. Eén naam, één e-mailadres, één datum voor herziening. Een beleid zonder eigenaar vervalt tot een wikipagina die niemand sinds de onboarding heeft geopend.
Print het, zet het in het personeelshandboek, besteed er een kwartier aan in een teamoverleg. Dat levert meer compliance op dan welke leveranciersvragenlijst ook.
Wat verandert er met een Europese aanbieder, en wat niet
Het maakt één gesprek korter. Draait de inferentie op infrastructuur binnen de Europese Unie, dan is de analyse van doorgifte niet langer de lastigste alinea in je documentatie, en krijgt de vraag “waar gaat deze data heen” een kort antwoord dat je in een privacyverklaring kunt zetten. Het is de moeite waard om het volledige pad van een verzoek één keer te begrijpen, want het is ook de vorm van het antwoord dat je je eigen klanten geeft.
Aan de andere drie voorwaarden verandert het niets. Je hebt nog steeds een grondslag nodig, een schriftelijke overeenkomst, een antwoord over bewaren en een beleid waar mensen zich aan houden. En het maakt de eigen keten van de aanbieder niet op wonderbaarlijke wijze Europees: de onze is volledig gepubliceerd, inclusief de drie partijen met een moederbedrijf in de Verenigde Staten, want een lijst die die verstopt, is marketing en geen transparantie. Wat het woord soeverein echt waard is, laag voor laag, ontleden we in Europese soevereine AI.
Vijf controles voordat je een tool goedkeurt
Doe ze vóór de pilot, niet na de uitrol. Ze kosten een middag.
- Zoek de verwerkersovereenkomst. Is die er niet, dan valt de tool af voor alles behalve openbaar materiaal.
- Doorzoek de voorwaarden op “train”. Lees elke treffer, ook die over “service improvement”, wat vaak hetzelfde is in een mooier jasje.
- Vraag om de lijst met subverwerkers. Met regio’s en rechtspersonen. Tel daarna de moederbedrijven buiten de EU, niet om ze uit te sluiten maar om het aantal te kennen.
- Vraag wat er met een prompt gebeurt na het antwoord. Hoe lang bewaard, voor wie zichtbaar, en kun je het uitzetten.
- Kijk wat je eigen privacyverklaring zou moeten zeggen. Kun je die alinea niet eerlijk schrijven, dan heb je je antwoord, en het kwam vóór het contract in plaats van erna.
Voor een eerste ronde heb je hier geen jurist voor nodig. Wel iemand met een middag tijd en de gewoonte om de clausule te lezen in plaats van de landingspagina. Komt een tool door die vijf, dan is de resterende vraag welk soort aanbieder je überhaupt wilt, en de vier realistische opties vergelijken we in Europese AI-aanbieders vergeleken.
Veelgestelde vragen
Voldoet ChatGPT aan de AVG?
Een tool is op zichzelf niet AVG-conform of in strijd met de AVG; de verwerking die je ermee doet wel. Een zakelijke versie met een getekende verwerkersovereenkomst, een clausule dat er niet getraind wordt en een vastgelegde bewaartermijn kun je AVG-conform gebruiken. Een persoonlijk account, gebruikt voor klantgegevens, waarvan niemand de voorwaarden heeft gelezen, meestal niet.
Mag ik klantgegevens in een AI-chatbot zetten?
Alleen als je een grondslag hebt, een verwerkersovereenkomst met de aanbieder en een clausule dat je invoer niet voor training wordt gebruikt. Houd ook dan bijzondere persoonsgegevens, zoals gezondheids- of biometrische gegevens, erbuiten, tenzij een gegevensbeschermingseffectbeoordeling (DPIA) iets anders zegt.
Mag je een gratis ChatGPT-account op het werk gebruiken?
Voor openbaar of al gepubliceerd materiaal is dat meestal prima. Voor alles wat intern, vertrouwelijk of persoonlijk is, is het de verkeerde tool: consumentenvoorwaarden staan training op je invoer vaak toe, bieden geen verwerkersovereenkomst en geven je organisatie geen controle over de bewaartermijn.
Wat is schaduw-AI?
Schaduw-AI is het gebruik van AI-tools die de organisatie niet heeft goedgekeurd, meestal via persoonlijke accounts. Het is de meest voorkomende route waarlangs bedrijfsdata bij een AI-aanbieder terechtkomt, en tools blokkeren maakt het eerder erger dan minder. Een goedgekeurde tool met een kort, geschreven beleid werkt beter.
Moeten we mensen vertellen dat we AI op hun gegevens gebruiken?
In de meeste gevallen wel. Door de transparantieplichten van de AVG moet je privacyverklaring vermelden dat een AI-aanbieder namens jou persoonsgegevens verwerkt, en de AI-verordening voegt daar een eigen plicht aan toe: mensen vertellen dat ze met een AI-systeem te maken hebben en niet met een mens.
Mogen advocaten of accountants ChatGPT gebruiken met klantdossiers?
Pas na controle van twee dingen die boven op de AVG komen: de regels voor beroepsgeheim van je eigen toezichthouder of beroepsorde, en de geheimhoudingsclausules in je opdrachtbevestigingen. Die vragen meestal om een verwerkersovereenkomst, een clausule dat er niet getraind wordt en een vastgelegd besluit over welke soorten dossiers überhaupt gebruikt mogen worden. Dit is een vraag voor je beroepsorganisatie, niet voor de marketingpagina van een leverancier.
Mogen we AI gebruiken om sollicitanten te selecteren?
Wees voorzichtig. De AVG beperkt besluiten die uitsluitend op geautomatiseerde verwerking berusten en iemand in aanmerkelijke mate treffen, en de Europese AI-verordening behandelt toepassingen bij werving en personeelszaken als hoog risico, met extra verplichtingen. AI gebruiken om een mens te helpen sollicitaties te lezen is iets anders dan het mensen laten afwijzen, en voor het tweede heb je een gedocumenteerde beoordeling nodig voordat het ook maar in de buurt van productie komt.