Prezzi delle API AI a token: quanto paghi davvero
Quanto costa un milione di token, perché l’output costa più dell’input e quando un abbonamento batte il pagamento a token. Prezzi reali in euro, senza asterischi.
Il prezzo a token vuol dire che paghi il testo a volume, e con due tariffe diverse: una per i token che invii, una più alta per i token che il modello ti restituisce. Su Union AI si va da 0,40 € per milione di token in input sul tier più economico a 12 € per milione di token in output su quello più potente, IVA esclusa. L’API non ha nessun abbonamento collegato, nessun minimo mensile e nessuna fattura che non hai generato tu.
Il problema è che un milione di token non è un’unità che si riesce a percepire. Questo articolo la trasforma in numeri concreti, con gli stessi prezzi su cui misura il nostro router.
Quanto costa un milione di token?
Ecco il listino completo. Quattro tier, due tariffe ciascuno, in euro, IVA esclusa.
| Tier | Adatto a | Input per 1M | Output per 1M | Contesto |
|---|---|---|---|---|
| Lite | Classificazione, estrazione, risposte brevi | 0,40 € | 1,60 € | 131.000 token |
| Standard | Il tuttofare: chat e quasi tutto il traffico API | 0,70 € | 3,50 € | 262.000 token |
| Contesto lungo | Fascicoli interi, contratti, codebase | 1,00 € | 2,00 € | 1 milione di token |
| Pro | Ragionamento complesso, agenti, codice difficile | 4,00 € | 12,00 € | 1 milione di token |
Due cose in questa tabella sorprendono. Il tier a contesto lungo costa meno in output del tuttofare, perché un modello costruito per un milione di token in input non è per forza il più forte nel ragionamento. E tra il tier più economico e il più caro c’è un fattore dieci: la scelta del tier sposta la tua spesa molto più di quanto farà mai l’ottimizzazione dei prompt.
La tabella completa, con un calcolatore e un confronto con i fornitori americani ai loro prezzi di listino, è sulla pagina dei prezzi. Quale modello open-weight c’è dietro ogni tier, e con quale licenza, lo trovi nella pagina sulla trasparenza sull’AI.
Quanti token sono una pagina, un messaggio, una codebase?
Un token è un pezzo di testo che il modello legge o scrive, di solito una parola comune o una sua parte. La regola approssimativa per l’inglese è mille token per circa 750 parole. Le altre lingue si tokenizzano in modo meno efficiente, quindi lo stesso testo in olandese, finlandese o polacco costa un po’ di più.
Qualche punto di riferimento per rendere concreta l’astrazione:
- Una domanda breve con un paragrafo di risposta: circa 300 token in input, 200 in output.
- Un messaggio medio, con un po’ di contesto e una risposta articolata: circa 900 in input e 500 in output. È l’ipotesi dietro ogni cifra della nostra pagina dei prezzi.
- Un contratto di 40 pagine: più o meno 20.000 token in input. Riassumerlo sul tier Standard costa una frazione di centesimo.
- Una codebase di medie dimensioni, diciamo 5.000 righe: sta comodamente nella finestra da 262.000 token del tier Standard, lontanissima dal milione del tier a contesto lungo.
Fai passare il messaggio medio dal tier Standard e ottieni 2,38 € per mille messaggi. È il numero da ricordare, perché cambia la prospettiva sull’intera questione: per la maggior parte dei team il modello non è la parte costosa del prodotto.
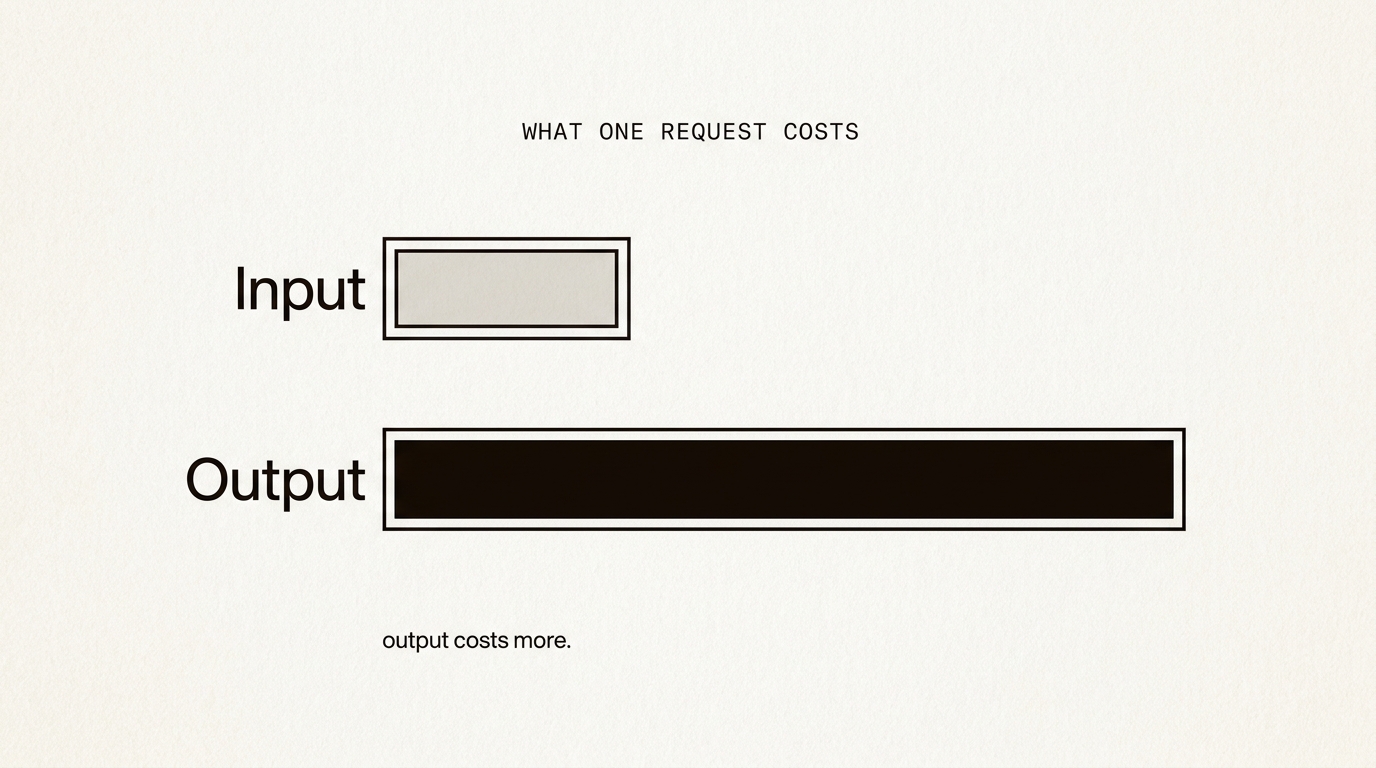
Perché l’output costa più dell’input?
Perché scrivere è un lavoro più lento che leggere. I token in input attraversano il modello in un unico passaggio parallelo, quindi un prompt lungo costa più o meno quanto suggerisce la sua lunghezza, non di più. I token in output escono uno alla volta, ognuno condizionato dal precedente, e l’hardware resta impegnato per tutta la sequenza. La tariffa più alta dell’output è quel tempo seriale.
La conseguenza pratica è un’abitudine da prendere: limita l’output, non l’input. Incollare un intero documento nel prompt di solito costa poco. Chiedere una risposta di mille parole quando ne bastano cento è ciò che si vede davvero in fattura. Impostare max_tokens è il controllo dei costi più efficace dell’API, ed è una riga sola.
Abbonamento alla chat
13,00 €
13 € al mese, 2000 messaggi inclusi su questo tier, il resto dal credito.
API, a token
4,76 €
0,70 € in input e 3,50 € in output per milione di token, nessun costo fisso.
Qui conviene l’API, di 8,24 € al mese.
Questo messaggio medio vale 900 token in input e 500 in output, le stesse ipotesi della pagina dei prezzi. Entrambe le cifre sono IVA esclusa, e il confronto riguarda solo il denaro: l’abbonamento compra anche un’interfaccia, gli allegati e le conversazioni condivise, che i token da soli non danno.
Il pagamento a consumo costa meno di un abbonamento?
A volumi bassi, quasi sempre. Qualche centinaio di messaggi al mese tramite API costa ben meno di un euro sul tier Standard, mentre qualsiasi abbonamento addebita la stessa cifra fissa che tu lo usi o no. Sotto i mille messaggi al mese, con il prezzo a token la partita non è nemmeno in equilibrio.
Il quadro si ribalta in tre casi, che il confronto qui sopra ti permette di trovare da solo:
- Messaggi lunghi. Un prompt da quattromila token con una risposta lunga costa diverse volte un messaggio medio, e la cifra fissa smette di sembrare assurda.
- Il tier costoso. Una risposta Pro pagata con il credito costa circa quattro volte una Standard, e nell’abbonamento alla chat conta come cinque messaggi sul totale mensile.
- Vuoi il prodotto, non il tubo. Il nostro abbonamento alla chat costa 13 € al mese, o 11 € al mese se paghi l’anno in anticipo, per un’interfaccia, gli allegati, i documenti lunghi e le conversazioni condivise. Costruirlo da solo sopra l’API ti costa più di 13 € del tuo tempo già il primo pomeriggio.
Un abbonamento è una scommessa su quanto costerà in media il tuo messaggio. Il prezzo a token è il rifiuto di scommettere.
Nessuno dei due modelli è più onesto dell’altro. Un prezzo è onesto se riesci a prevederlo prima di impegnarti, ed è per questo che il nostro stimatore dichiara le sue ipotesi invece di mostrare una cifra mensile dall’aria rassicurante.
Cosa nasconde il prezzo a token
Quattro cose che rendono le fatture reali diverse dal calcolo sulla carta. Nessuna è un trucco, e tutte colgono le persone di sorpresa.
La cronologia della conversazione viene rinviata a ogni turno
Una chiamata API è stateless. Il decimo turno di una conversazione invia con sé i turni dall’uno al nove, quindi i token in input crescono con la lunghezza del thread. Una chat lunga può spendere di più per rileggere la propria cronologia che per qualsiasi cosa nuova. Tagliare o riassumere i turni vecchi non è un’ottimizzazione prematura, è la leva principale.
Retry e agenti moltiplicano le richieste
Una sola azione dell’utente in un loop di agenti può valere venti chiamate al modello. Moltiplica il costo per richiesta per il loop, non per l’utente. Poi controlla cosa succede quando il loop non termina: è a questo che servono i tetti descritti nella prossima sezione.
Le tariffe in vetrina non sono tutto il listino
I fornitori pubblicano sconti per l’input in cache, per i job in batch e per la spesa impegnata. Sono sconti reali, e significano che un confronto regge solo se entrambe le parti sono quotate alla tariffa standard. La nostra tabella di confronto usa i prezzi di listino da entrambe le parti proprio per questo, con il tasso di cambio e la data di lettura riportati sotto, e gli stessi numeri sono analizzati fornitore per fornitore in fornitori di AI europei a confronto.
Anche il lavoro fallito costa, a meno che qualcuno non decida diversamente
Se un modello restituisce qualcosa di inutilizzabile, la maggior parte dei contatori ha già conteggiato i token. Noi la vediamo in un altro modo: una richiesta che non ha prodotto una risposta utilizzabile non toglie nulla dal tuo saldo, e una richiesta reindirizzata che finisce su un modello più debole viene addebitata alla più bassa delle due tariffe. La documentazione elenca gli header che ti dicono quale delle due cose è successa.
Si paga l’IVA sul credito AI prepagato?
Dipende da chi sei e da dove sei. Se sei un’azienda in un altro paese dell’UE con una partita IVA valida, si applica l’inversione contabile (reverse charge): non aggiungiamo l’IVA e la versi tu. La guida della Commissione europea sull’IVA transfrontaliera sui servizi lo dice chiaramente: con il meccanismo dell’inversione contabile i clienti pagano l’IVA sui servizi ricevuti con l’aliquota del proprio paese.
Se non hai una partita IVA valida, o se acquisti come consumatore, si applica l’IVA del paese in cui ti trovi. Ogni prezzo su questo sito è indicato IVA esclusa, e la tua fattura indica quale dei due trattamenti è stato applicato.
Come evitare che la spesa in token sfugga di mano
Il problema non è mai il prezzo per milione. È un loop, una chiave finita nelle mani sbagliate o un job rimasto acceso tutto il weekend. Cinque difese, nell’ordine in cui conviene impostarle:
- Imposta un tetto per chiave, in euro, giornaliero e mensile. Una chiave senza tetto è un assegno in bianco.
- Imposta
max_tokenssu ogni chiamata. Vedi la tariffa dell’output qui sopra. - Leggi
X-EU-Cost-EURnella risposta. Ogni richiesta ti dice quanto ha tolto dal tuo saldo, così i tuoi log rispondono alla domanda sui costi senza bisogno di una dashboard. - Tieni basso il saldo. Il credito prepagato ha un limite invalicabile a zero, ed è una caratteristica voluta. Una ricarica da 10 € non può diventare una sorpresa da 4.000 €.
- Lascia lavorare il controllo delle anomalie. Se vediamo più di dieci volte la tua media settimanale nell’arco di un’ora, mettiamo in pausa la chiave e ti mandiamo un’email. I nuovi account hanno un tetto di 25 € al giorno per le prime 48 ore, qualunque sia il saldo.
Quest’ultima difesa ogni tanto costa un falso allarme. Pensiamo che un job in batch interrotto sia meglio di un portafoglio vuoto, e puoi alzare il tetto da solo quando sai che quel traffico è tuo.
Quanto costa iniziare
Dieci richieste API sono gratuite, la ricarica minima è di 10 € e il credito resta valido per 24 mesi. Per provare la chat non serve una carta: hai 5 messaggi gratuiti prima che ti venga chiesto qualcosa.
Spostare un’integrazione esistente per vedere questi numeri sul tuo traffico richiede una chiave, un base URL e il nome di un tier, ed è l’argomento di come cambiare fornitore in tre righe.
Questa è tutta la parte commerciale. Se vuoi l’altra metà, cioè dove vengono elaborati quei token e chi può leggerli lungo il percorso, l’articolo gemello sulla residenza dei dati dell’AI nell’UE segue la stessa richiesta passo dopo passo, e AI sovrana europea spiega quanto vale la parola sovrano una volta smontata.
Domande frequenti
Quanto costa un milione di token?
Dipende dal modello e dal fatto che i token entrino o escano. Su Union AI un milione di token in input costa tra 0,40 e 4 euro a seconda del tier, e un milione di token in output tra 1,60 e 12 euro, IVA esclusa. L’output è sempre la metà più cara, presso qualsiasi fornitore.
Che cos’è un token in un’API AI?
Un token è un pezzo di testo che il modello legge o scrive, di solito una parola comune o una sua parte. Come regola approssimativa per l’inglese, mille token sono circa 750 parole, quindi una pagina A4 di prosa si aggira sui 500 token. La fatturazione conta separatamente i token che invii e quelli che il modello genera.
Perché l’output costa più dell’input?
Perché generare testo è un lavoro più lento che leggerlo. I token in input possono essere elaborati in un unico passaggio parallelo, mentre quelli in output vengono prodotti uno dopo l’altro, ognuno in attesa del precedente. La tariffa più alta dell’output paga proprio questa differenza di tempo di calcolo.
Il pagamento a consumo costa meno di un abbonamento AI?
A volumi bassi, quasi sempre. Qualche centinaio di messaggi al mese tramite API spesso costa meno di un euro, mentre un abbonamento addebita una cifra fissa che tu lo usi o no. L’abbonamento vince quando i tuoi messaggi sono lunghi, quando usi il modello costoso o quando vuoi un’interfaccia pronta invece di un’API.
Quanti token sono un documento di 40 pagine?
Circa 20.000 token in input per 40 pagine di prosa normale, con la regola di circa 750 parole ogni mille token. Su un tier di fascia media leggerlo costa una frazione di centesimo, ed è per questo che raramente è l’input lungo a far lievitare una spesa AI.
Perché la mia spesa AI è cresciuta più in fretta del mio utilizzo?
Quasi sempre perché la cronologia della conversazione viene rinviata a ogni turno. Una chiamata API è stateless, quindi il decimo turno si porta dietro i turni dall’uno al nove, e i token in input crescono con la lunghezza del thread invece che con il numero di utenti. I loop degli agenti fanno lo stesso, trasformando una sola azione dell’utente in venti richieste fatturate.
Come stimo i costi di un LLM prima di sviluppare?
Prendi una richiesta realistica, conta separatamente i token in input e in output e moltiplica per il volume previsto alle tariffe per milione del fornitore. Poi raddoppia il valore dell’output come margine di sicurezza e aggiungi tutto ciò che il tuo progetto rinvia, come la cronologia della chat o i documenti recuperati. Di solito quella stima azzecca l’ordine di grandezza, ed è tutto ciò che serve per decidere se sviluppare.