AI sovrana europea: cosa significa in pratica
L’AI sovrana sono quattro domande distinte: l’edificio, il gestore, i pesi e i valori. A cosa sa rispondere oggi l’Europa, e cosa puoi fare in questo trimestre.
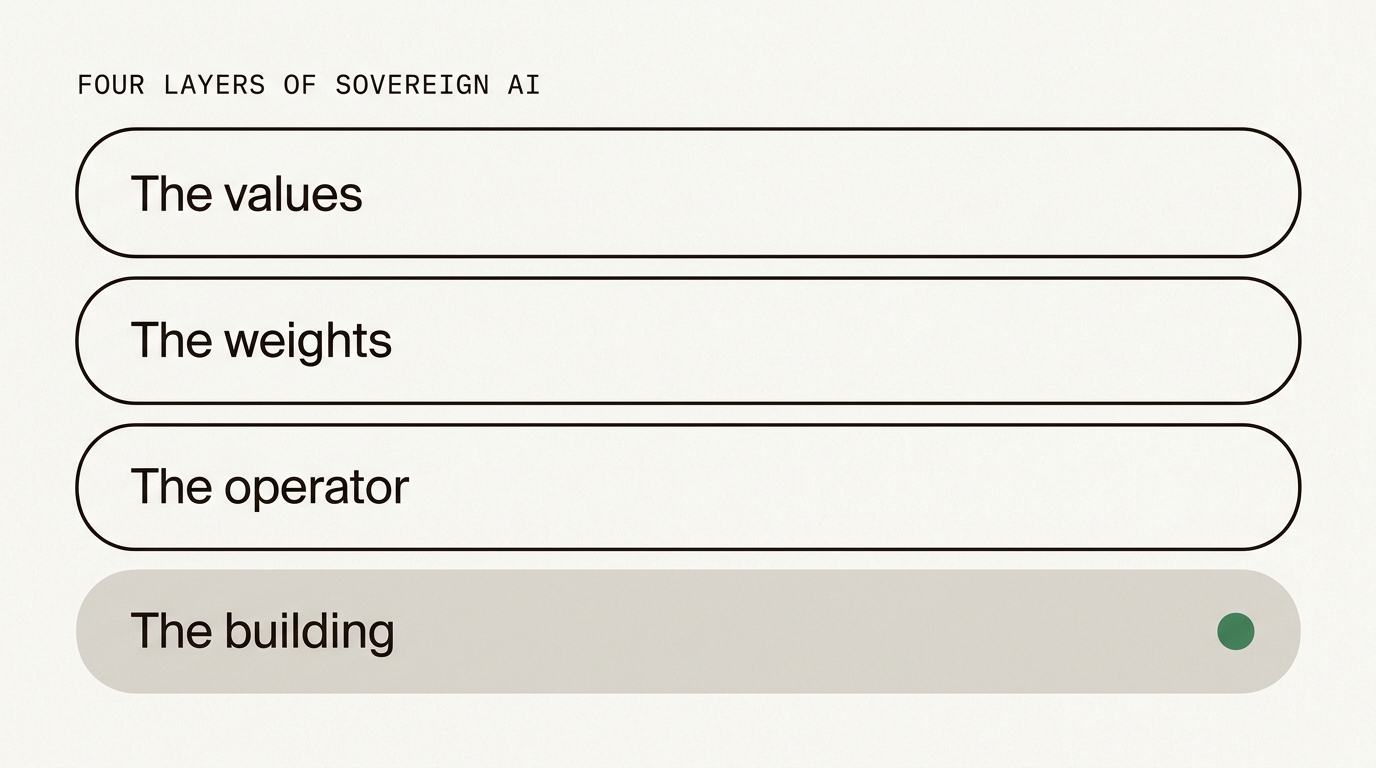
L’AI sovrana non è una sola proprietà. Sono quattro domande una sopra l’altra: dove si trova l’hardware, quale Stato può obbligare l’azienda che lo gestisce, chi ha addestrato il modello e quali presupposti si porta dietro il modello. L’Europa sa rispondere bene alla prima, alla seconda con qualche riserva, e alla terza e alla quarta solo in parte. Chi ti vende tutte e quattro in una parola ti sta vendendo un’ambizione.
Vale la pena dirlo chiaramente prima che entri in scena qualsiasi prodotto, compreso il nostro. La versione utile di questo dibattito non è «europeo o americano». È: di quale strato ha davvero bisogno questo specifico carico di lavoro, e quanto costa spostarlo?
Cosa significa davvero AI sovrana
La parola viene dal dibattito sulla capacità di calcolo, dove aveva un significato preciso: uno Stato dovrebbe poter far girare i sistemi critici senza il permesso di un altro Stato. Applicata all’AI, si è allargata fino a coprire tutto, dal codice postale dei data center all’orientamento politico di un chatbot, e per strada ha perso quasi tutta la sua utilità.
Scomponila di nuovo nelle sue parti e ognuna diventa verificabile.
La sovranità non è un bollino su una landing page. Sono quattro domande con quattro risposte diverse, e i fornitori onesti ti dicono a quali rispondono.
L’edificio è geografia: in quale paese si trova l’hardware. Il gestore è giurisdizione: quale ordinamento giuridico vincola l’azienda che gestisce quell’hardware. I pesi sono provenienza: chi ha addestrato il modello, su quali dati, con quale licenza. I valori sono comportamento: cosa dice il modello, cosa rifiuta e cosa sbaglia senza farsi notare sulla tua parte di mondo.
Chi può fornire ogni strato in Europa oggi
| Strato | La domanda | L’Europa oggi |
|---|---|---|
| L’edificio | Dove si trova l’hardware? | Risolto. La capacità europea è reale e prenotabile |
| Il gestore | Quale Stato può obbligare il gestore? | Disponibile per l’inferenza, più difficile per hosting, database e pagamenti |
| I pesi | Chi ha addestrato il modello? | Scarso ma in crescita, con un divario di calcolo che si sta colmando ora |
| I valori | Cosa dirà e cosa rifiuterà il modello? | In parte, e soprattutto tramite documentazione più che tramite addestramento |
Più sali, più gli strati diventano difficili, e il prezzo di ciascuno sale di pari passo. Noleggiare capacità di calcolo europea è una decisione di acquisto. Addestrare in Europa un modello di frontiera competitivo è un progetto industriale di diversi anni, ed è esattamente a questo che serve l’attuale ondata di fondi UE.
Dove si trova fisicamente l’hardware?
- Cosa può fornire l’Europa oggi
- Risolto. La capacità dei data center europei è reale, prenotabile e in crescita.
- Cosa fa Union AI
- Tutta l’inferenza AI gira su infrastruttura dentro l’Unione europea.
Un pallino verde su quattro. Qualsiasi fornitore che oggi dichiari tutti e quattro sta descrivendo un’ambizione, non uno stack che puoi comprare.
Esistono LLM europei che vale la pena usare?
Sì, e il quadro onesto è quello di un settore giovane più che di uno maturo. Si divide in due tipi di impegno.
Il primo è commerciale. I laboratori europei rilasciano modelli open-weight che puoi scaricare e far girare da solo, e i loro modelli più piccoli sono davvero competitivi per il lavoro quotidiano. È la parte dello stack europeo che oggi funziona già in produzione.
Il secondo è pubblico. OpenEuroLLM è un consorzio di università, centri HPC e aziende europee, finanziato dal programma Europa digitale, che costruisce modelli di base aperti per le lingue ufficiali dell’UE e pubblica dati, codice e valutazioni insieme ai pesi. Quest’ultima parte conta più dei punteggi del modello: un modello con dati di addestramento e valutazioni pubblici è un modello che puoi verificare, e alla frontiera oggi non è verificabile quasi nulla.
Sotto entrambi c’è la capacità di calcolo. Il programma delle gigafactory dell’AI della Commissione mobilita 20 miliardi di euro tramite lo strumento InvestAI per una capacità di addestramento su larga scala in Europa, e la manifestazione d’interesse informale ha raccolto 77 proposte da 16 Stati membri e 60 siti, con la costruzione del primo sito prevista dal 2027. Se questo colmerà il divario di capacità è una domanda aperta. Significa però che la risposta nel 2029 non sarà quella di oggi, ed è un motivo per tenere portabile il tuo stack, non per aspettare.
Un modello può essere addestrato sui valori europei?
In parte, e l’espressione merita più attenzione di quella che riceve di solito. «Addestrato sui valori europei» fa tre lavori diversi, e solo due sono verificabili.
La lingua è un valore, ed è misurabile
Un modello che gestisce l’olandese, il finlandese, il greco e il portoghese bene quanto l’inglese è, per gli utenti europei, un prodotto diverso da uno che le tratta come ripensamenti. La copertura linguistica si testa in un pomeriggio: usa i tuoi prompt, nelle tue lingue, e confronta. È il test più utile di tutto il dibattito sulla sovranità, e quasi nessuno lo fa prima di comprare.
Il modo di rifiutare rivela l’addestramento
Alcuni modelli open-weight sono addestrati sotto ordinamenti giuridici con le proprie sensibilità, ed evitano domande fattuali su politica o storia che un utente europeo considererebbe del tutto normali. Noi lo trattiamo come un difetto, non come una funzione di sicurezza. Quando il nostro sistema rileva questo tipo di rifiuto nella prima frase di una risposta, annulla la risposta e ripete la domanda su un modello senza quel punto cieco, al massimo una volta per richiesta, e ti dice che è successo nell’header X-EU-Routed. Quello che non facciamo è aggirare i rifiuti legati a una vera questione di sicurezza: quelli restano rifiuti, perché reindirizzare finché un modello non cede è un jailbreak automatico.
Tutto il resto è documentazione, non addestramento
Il resto di quello che si intende con valori, cioè che un modello sia equo, equilibrato e appropriato, non è qualcosa che puoi verificare da una pagina di marketing. Quello che puoi verificare è se il fornitore pubblica il modello, la licenza, il system prompt e il tasso di rifiuto misurato. Noi pubblichiamo tutti e quattro nella pagina sulla trasparenza sull’AI, comprese le parti che ci fanno fare brutta figura.
La sicurezza dei dati richiede un modello europeo?
No, e confondere le due cose costa ai team soldi veri. Dove è stato addestrato un modello e dove viene elaborato il tuo prompt sono fatti indipendenti.
I pesi sono un file. Scarichi un modello open-weight, lo fai girare su hardware europeo, e il tuo prompt va a quell’hardware e torna indietro, chiunque l’abbia addestrato. Con i pesi viaggia il comportamento, non il flusso dei dati. Per questo il nostro stack può dire onestamente che usa soprattutto modelli non europei pur elaborando ogni richiesta dentro l’Unione europea, e per questo il percorso della richiesta conta di più per la protezione dei dati della storia d’origine del modello.
Le quattro domande sulla sicurezza dei dati da fare a qualsiasi fornitore, europeo o no: dove viene elaborata l’inferenza, per quanto tempo vengono conservati i prompt, se vengono usati per l’addestramento e quali soggetti della catena hanno una capogruppo fuori dall’UE. Le nostre risposte sono sulla pagina dei sub-responsabili, comprese quelle scomode.
Cosa puoi fare davvero in questo trimestre
La sovranità come decisione d’acquisto fallisce, perché niente sul mercato supera tutti e quattro gli strati. La sovranità come sequenza di piccole mosse funziona. Più o meno in ordine di resa:
- Classifica i carichi di lavoro prima dei fornitori. La maggior parte dei team ha una fetta di traffico davvero sensibile e una grande maggioranza di traffico normale. Conoscere la proporzione cambia quali compromessi vale la pena pagare.
- Sposta prima la fetta sensibile. Contratti con i clienti, fascicoli HR, note sui pazienti, codice non ancora pubblicato. Lascia dov’è il riassunto delle pagine web pubbliche.
- Chiedi per iscritto l’elenco dei sub-responsabili e la clausola sull’addestramento. Non una call commerciale. Un elenco con regioni ed entità giuridiche, più una ricerca della parola «addestramento» (o «train») nei termini.
- Tieni noiosa l’interfaccia. Un’API compatibile con OpenAI vale più di qualsiasi dichiarazione di sovranità, perché rende economico cambiare. La portabilità è l’unica forma di potere negoziale che sopravvive a un fornitore che cambia idea. La nostra è documentata nel riferimento dell’API, e cosa comporta davvero un cambio lo trovi in come cambiare fornitore in tre righe.
- Registra le prove richiesta per richiesta. Un header che indica il tier, i conteggi dei token e il costo trasforma un’affermazione in una traccia di audit.
- Rifai il test tra sei mesi. Il panorama dei modelli europei si muove più in fretta di qualsiasi ciclo di acquisto. Le ipotesi dell’anno scorso sono già vecchie.
Niente di tutto questo richiede di ricostruire, e tutto regge comunque vada il mercato.
Dove ci collochiamo, e dove no
Union AI è un servizio europeo che fa girare modelli open-weight, con tutta l’inferenza AI su infrastruttura dentro l’Unione europea, pagamento anticipato in euro e prezzo a token. Copriamo del tutto lo strato più basso, gran parte di quello del gestore, e siamo trasparenti sui due sopra.
I nostri modelli sono open-weight con licenza Apache 2.0 e MIT, e la maggior parte non è stata addestrata in Europa. L’unico modello addestrato in Europa oggi nel nostro stack è il modello Mistral su cui ripieghiamo nel tier più economico quando quello principale si guasta. Preferiamo scrivere questa frase piuttosto che lasciare che la parola sovrano faccia il lavoro al posto nostro.
Come ci confrontiamo con gli altri tre modi di comprare AI in Europa, comprese le righe in cui perdiamo, lo trovi in fornitori di AI europei a confronto.
Quindi la proposta è volutamente limitata. Se vuoi che i tuoi prompt vengano elaborati in Europa, da un fornitore europeo, su modelli con un comportamento documentato e una spesa prevedibile, esiste oggi e puoi iniziare questa settimana. Se vuoi un modello di frontiera europeo addestrato su dati europei, lo si sta costruendo, con soldi pubblici e una tabella di marcia pubblicata, e né noi né nessun altro possiamo ancora vendertelo.
Domande frequenti
Che cos’è l’AI sovrana?
L’AI sovrana è l’idea che un paese o un’unione possa far girare sistemi di AI che controlla, alle proprie condizioni. In pratica si divide in quattro domande: dove si trova l’hardware, quale Stato può obbligare il gestore, chi ha addestrato il modello e di chi sono i valori che il modello riflette. La maggior parte dei fornitori risponde a una delle quattro e usa la parola per tutte.
Mi serve un LLM europeo per rispettare l’AI Act?
No. L’AI Act regola come i sistemi di AI vengono costruiti, documentati e presentati alle persone, non dove è stato addestrato il modello. Un modello open-weight americano o cinese può essere usato in modo conforme, e un modello europeo può essere usato in modo non conforme. La conformità riguarda i tuoi obblighi come fornitore o deployer, non il passaporto dei pesi.
I modelli open-weight sono la stessa cosa dell’open source?
No, e la differenza conta. Open-weight significa che puoi scaricare il modello e farlo girare da solo, di solito con una licenza come Apache 2.0 o MIT. Open source nel senso pieno vorrebbe dire anche dati di addestramento pubblicati e codice di addestramento riproducibile, cosa che la maggior parte dei modelli open-weight non offre.
Posso usare un modello open-weight cinese e tenere comunque i dati in Europa?
Sì. I pesi sono un file. Una volta scaricato un modello e fatto girare su infrastruttura europea, i tuoi prompt vanno a quell’hardware e da nessun’altra parte, chiunque abbia addestrato il modello. Con i pesi non viaggiano i tuoi dati ma il comportamento del modello, compresi gli argomenti che è stato addestrato a evitare.
Far girare un modello in Europa rende sicuri i miei dati?
Elimina una categoria di rischi e ne lascia altre. Significa che i tuoi prompt vengono elaborati su infrastruttura europea invece di essere mandati all’estero, ma non dice nulla sulla conservazione, sull’addestramento con i tuoi input, sul controllo degli accessi o sul fatto che il gestore abbia una capogruppo fuori dall’UE. Chiedi di tutte e quattro le cose separatamente.
Cosa significa che un modello è addestrato sui valori europei?
In pratica significa tre cose verificabili: che gestisce bene le lingue europee, che risponde alle domande fattuali su politica e storia invece di evitarle, e che i suoi dati di addestramento e il suo modo di rifiutare sono documentati. Non è uno slogan che puoi verificare, quindi trattalo come una serie di test da fare più che come un’etichetta di cui fidarti.
Quali progetti UE stanno addestrando modelli linguistici europei?
OpenEuroLLM è il più visibile: un consorzio di università, centri HPC e aziende europee, finanziato dal programma Europa digitale, che costruisce modelli aperti per le lingue ufficiali dell’UE e pubblica dati e valutazioni insieme ai pesi. Sotto c’è il programma delle gigafactory dell’AI della Commissione, che mobilita 20 miliardi di euro tramite lo strumento InvestAI per la capacità di addestramento di cui quei modelli hanno bisogno.